本章目录
第 2 章:规划与执行
2.1 简单查询协议
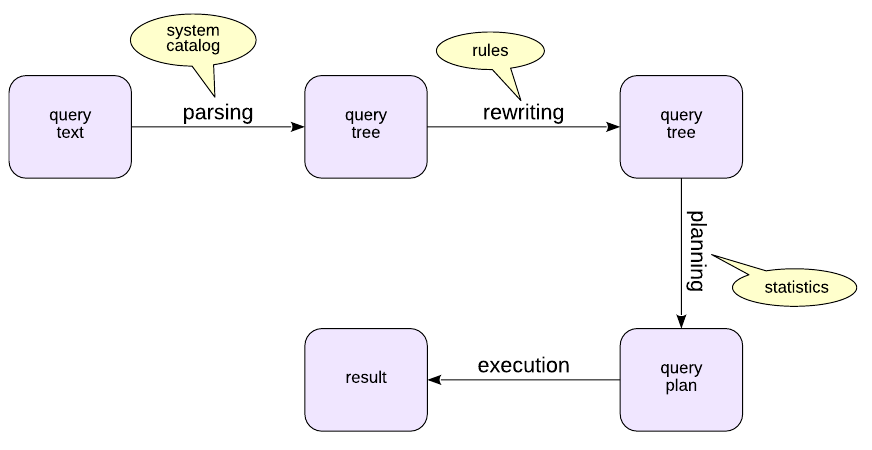
先来看最简单的情况:当你在 psql 中输入一条命令,比如 SELECT 时,会发生什么?查询处理需要经过几个阶段:1
- 解析
- 转换
- 规划 (优化)
- 执行
2.1.1 解析
词法和语法分析。第一步是解析:PostgreSQL 将查询文本拆分为标识符、数字、字符串字面量等词素,并检查这些词素是否组成了符合语法的结构。
来看一条简单的查询:
SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;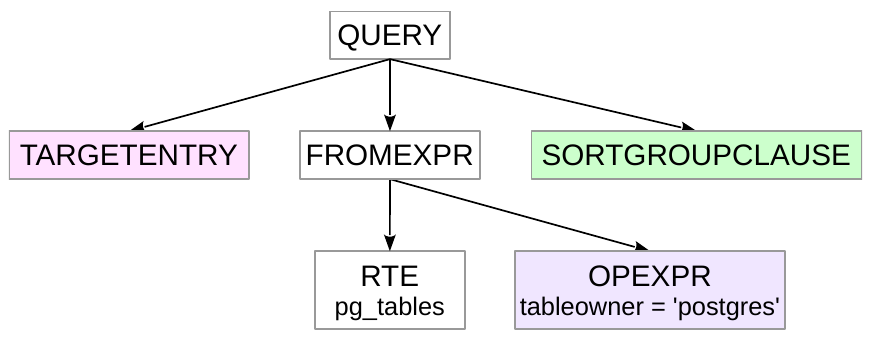
在这一阶段,后端进程会在内存中构建语法树。上图展示了这棵树的简化版本,颜色大致标出了查询文本各部分与树节点之间的对应关系。
RTE 是 Range Table Entry 的缩写,这个名称单从字面上并不容易理解。PostgreSQL 在内部使用 RTE 表示表、子查询、连接结果,以及其他可以出现在 SQL 查询中的行集。
语义分析。接下来进行语义分析,在 PostgreSQL 中称为 parse analysis。在这一阶段,PostgreSQL 确定查询引用了哪些数据库对象,以及用户是否有权访问它们。
SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;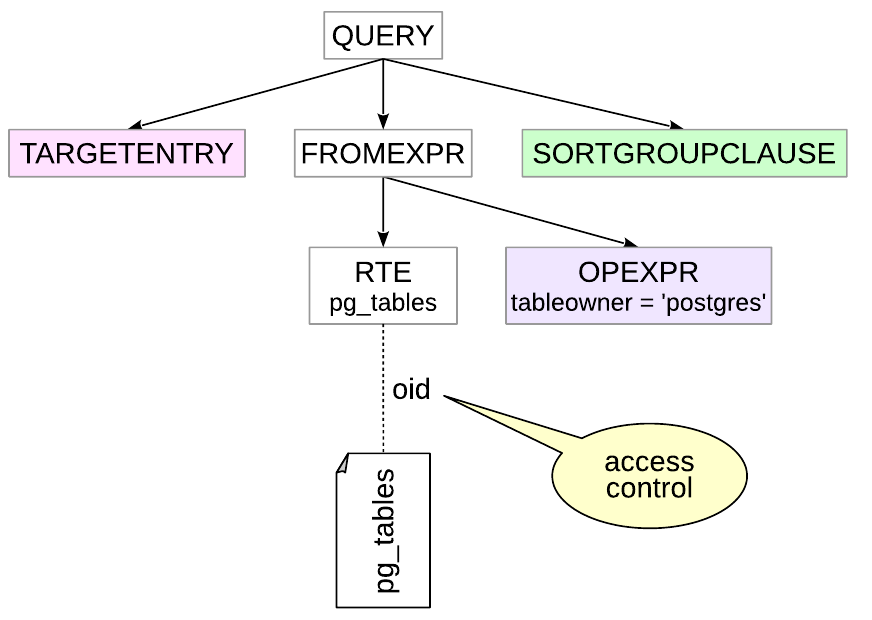
在语义分析过程中,PostgreSQL 会查询系统目录。在本例中,它将 pg_tables 这个名称解析为系统目录中由某个 oid 标识的具体视图,同时检查对该视图的访问权限。
2.1.2 转换
随后,查询会按照规则进行转换 (重写)。
视图是一个重要的特例:对视图的引用会被展开为定义该视图的查询。严格来说,处理过程并不像这个简化的阶段划分那样界限分明,因为视图定义本身也需要经过解析和分析。
对于本例,转换结果可以大致表示如下:
SELECT schemaname, tablename
FROM (
  SELECT ...
  FROM pg_class c
    LEFT JOIN pg_namespace n
      ON n.oid = c.relnamespace
    LEFT JOIN pg_tablespace t
      ON t.oid = c.reltablespace
  WHERE c.relkind = 'r'::"char"
)
WHERE tableowner = 'postgres'
ORDER BY tablename;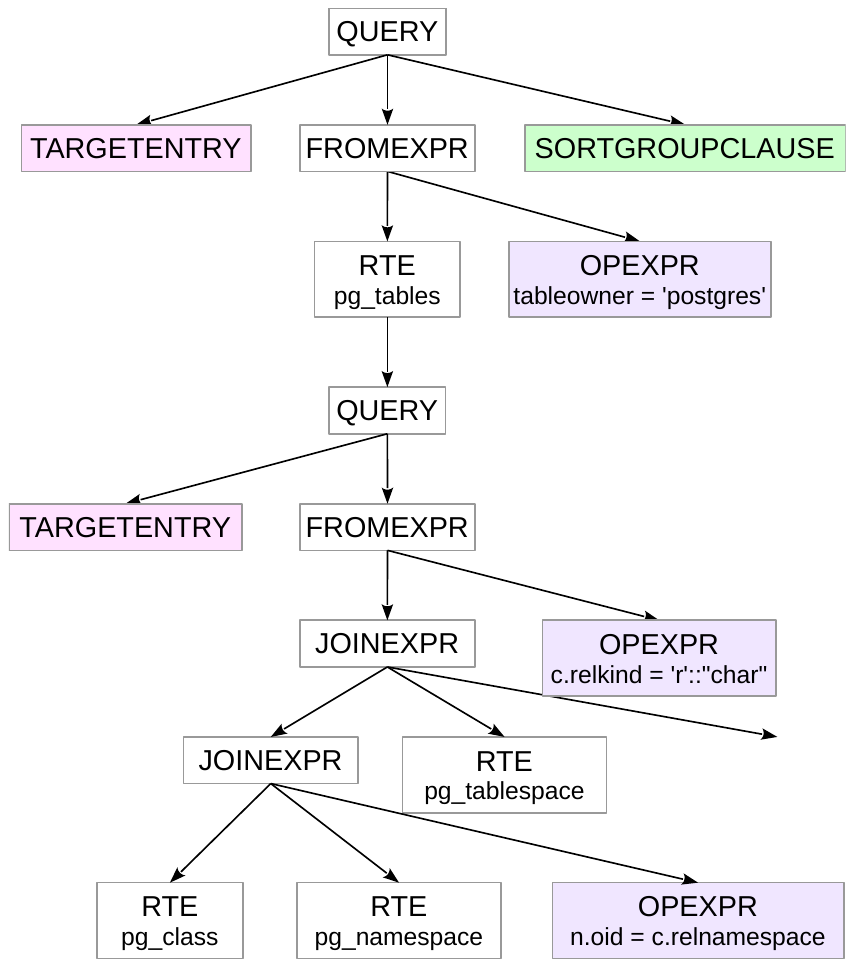
这里的 SQL 仅用于示意。转换操作作用于查询树,并不是对 SQL 文本进行替换。在树中,视图查询对应的节点被连接到 pg_tables 的 RTE 下方。
2.1.3 规划
接下来,PostgreSQL 对查询进行规划。
规划器会考虑执行查询的不同方式,并利用数学模型,根据称为统计信息的数据描述来估算这些方式的成本。估算成本最低的候选方案会被表示为一棵计划树。
本例的部分计划如下:
Sort
  Sort Key: c.relname
  ->  Nested Loop Left Join
        Join Filter: (n.oid = c.relnamespace)
        ->  Seq Scan on pg_class c
              Filter: ((relkind = 'r'::"char") AND pg_ge...
        ->  Seq Scan on pg_namespace n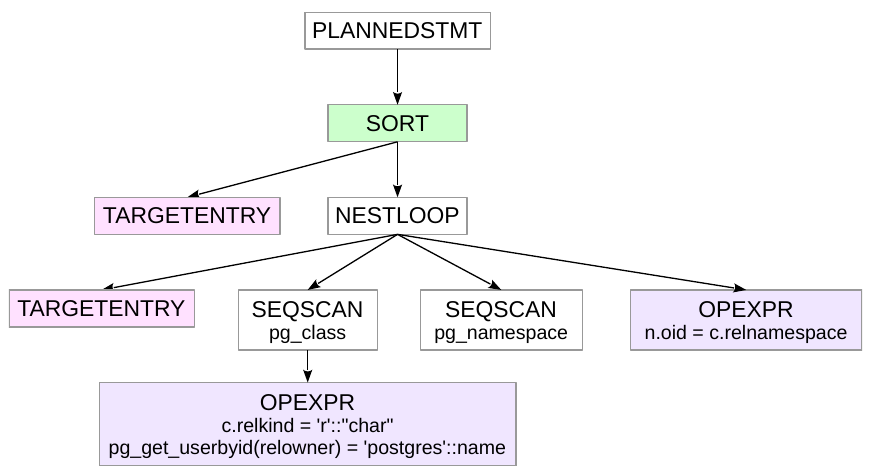
Seq Scan 从表中读取行,Nested Loop 则连接两个行集。图中对应的文本表示形式,就是 EXPLAIN 命令输出的形式。后续章节会详细讨论访问方法和连接方法。
注意,原来的三张表现在只剩下两张:规划器判断其中一张表并不是生成结果所必需的,因此将它从计划中移除了。
2.1.4 执行
最后,执行器运行选定的计划,并将结果返回给客户端。
计划树像一条流水线一样工作。下图重新绘制了这棵树,只保留其中的主要结构。
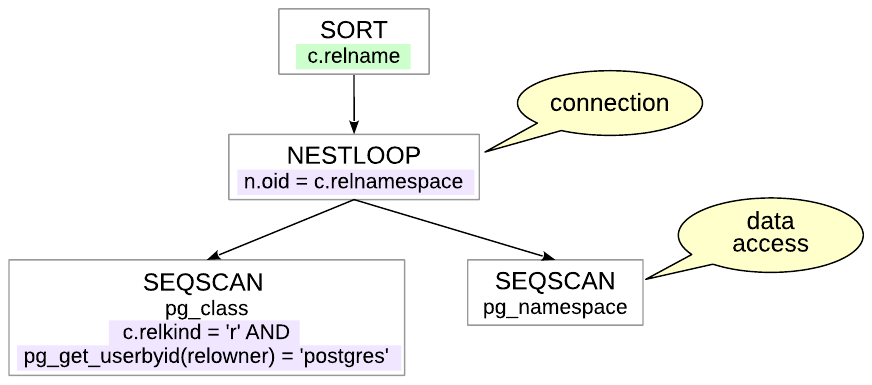
执行从树的根节点开始。根节点 (本例中是 Sort) 向子节点请求数据。获取所需数据后,它执行自身的操作,并将结果行向上传递,最终交给客户端。
Nested Loop 这样的节点会合并来自不同来源的数据。连接节点向两个子节点请求行,按照连接条件进行比较,然后将匹配的行对返回给父节点。底层的 Seq Scan 节点从相应的表中获取行,并向上传递给连接节点。
有些节点必须接收完所需的全部输入,才能返回任何结果。普通排序就是一个例子:只有先获取输入数据,才能确定排序后的顺序。
另一些节点则可以随接收随返回。例如,表扫描通常可以在仍然读取表的同时就返回行。这使得查询有可能很快返回一部分结果,例如应用按页显示数据时。PostgreSQL 文档将执行器的这一机制称为 demand-pull pipeline:父节点向子节点请求下一行,请求再沿计划树向下传递。
2.2 扩展查询协议
默认情况下,客户端使用简单查询协议:它向服务器发送一条 SQL 语句;如果是 SELECT 或带有 RETURNING 的命令,就接收返回的结果行。
例如:
SELECT model FROM airplanes WHERE airplane_code = '77W';

      model
------------------
 Boeing 777-300ER
(1 row)
使用简单查询协议时,每条查询都会经过前面介绍的全部处理阶段,即使同一条查询被反复执行也是如此。
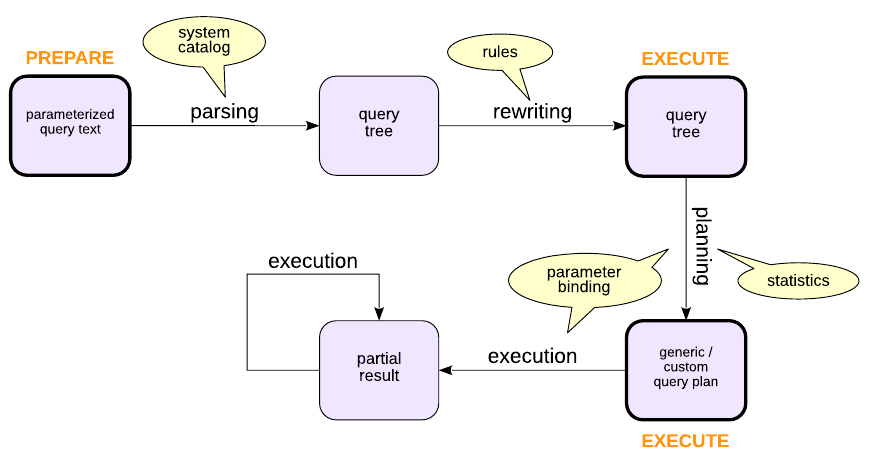
PostgreSQL 还提供扩展查询协议,将查询处理拆分为更明确的步骤。在实际使用中,这些步骤可用于语句预备和游标操作。2
2.2.1 预备语句
为了预备一条语句,客户端向服务器发送查询,其中可以包含参数。服务器对查询进行解析、分析和转换,并将预备语句的状态保存在后端进程中。
执行预备语句时,客户端提供各个参数的值。随后,PostgreSQL 可以构建一个考虑了这些具体值的 custom plan,并执行它。
在同一会话中多次执行相同语句时,预备语句可以避免重复进行解析、分析和转换。
如果语句不包含参数,就没有必要每次执行时都重新规划,因此 PostgreSQL 可以复用一个 generic plan。
如果语句包含参数,PostgreSQL 起初可以使用 custom plan;如果估算表明 generic plan 的平均表现并没有明显逊色于 custom plan,之后可能切换为 generic plan。第 6 章“统计信息”会进一步讨论这一选择。
预备语句也是防止 SQL 注入的重要手段:来自不可信来源的值可以作为参数单独发送,而不必拼接到 SQL 文本中。这种保护适用于通过参数传递的值;表名、列名等动态 SQL 结构仍然需要以安全的方式构造。
预备一条带参数的语句:
PREPARE model(varchar) AS
SELECT model
FROM airplanes
WHERE airplane_code = $1;

PREPARE
通过名称执行它:
EXECUTE model('CR7');

       model
-------------------
 Bombardier CRJ700
(1 row)
执行时,先绑定参数值,再根据需要对语句进行规划,然后执行。
可以通过 pg_prepared_statements 视图查看预备语句:
SELECT * FROM pg_prepared_statements \gx

-[ RECORD 1 ]---+--------------------------------
name            | model
statement       | PREPARE model(varchar) AS       +
                | SELECT model                   +
                | FROM airplanes                 +
                | WHERE airplane_code = $1;
prepare_time    | 2026-09-25 17:14:48.990998+03
parameter_types | {"character varying"}
result_types    | {text}
from_sql        | t
generic_plans   | 0
custom_plans    | 1
最后两列分别表示语句使用 generic plan 和 custom plan 的次数。不再需要某条预备语句时,可以通过 DEALLOCATE 将其移除。
PREPARE、EXECUTE 和 DEALLOCATE 都是 SQL 命令。其他编程语言以不同的方式提供相同的功能,但数据库驱动最终使用的是同一套客户端/服务器协议。
2.2.2 游标
游标允许逐步获取查询结果,而不是一次接收所有行。应用通常使用命令式语言编写,并以迭代方式处理结果集,因此游标很常见。
有关已打开游标的信息保存在后端进程中。
在 SQL 中声明一个游标,并获取第一行。游标通常存在于事务之内:
BEGIN;
BEGIN
DECLARE c CURSOR FOR SELECT * FROM airplanes;
DECLARE CURSOR
FETCH c;

 airplane_code | model           | range | speed
---------------+-----------------+-------+-------
 32N           | Aerobus A320neo |  6500 |   830
(1 row)
获取第二行 (事务结束时,游标会自动关闭):
FETCH c;

 airplane_code | model               | range | speed
---------------+---------------------+-------+-------
 339           | Aerobus A330-900neo | 13300 |   870
(1 row)

COMMIT;
COMMIT
数据库 API 提供了判断是否还有结果数据的方法,因此应用可以在循环中从游标获取数据。
2.3 深入探讨规划
规划值得进一步讨论:它既是影响查询性能的关键环节,也是查询处理中较为复杂的阶段之一。
2.3.1 规划过程
规划器会探索不同的执行计划,估算其成本,并从找到的计划中选择成本最低的一个。
计划节点的成本取决于执行的操作,以及所处理数据的特征。从表中顺序读取行,与通过索引获取行,显然使用不同的成本模型;所处理的数据量也会产生很大影响。
估算数据量时,以下两个概念尤其重要:
- 基数:节点预计输出的行数。
- 选择率:输入行中满足某个条件 (或称谓词) 的行所占的比例。
估算选择率和基数,需要了解表的大小、列值的分布等数据信息。这就涉及统计信息。PostgreSQL 通过 autovacuum 的自动分析任务,以及 ANALYZE 命令收集和更新统计信息。
基数估算错误是导致计划不佳的主要原因之一:统计信息不充分、现有统计信息没有描述的数据相关性、缺少有用统计信息的表达式,或规划器估算模型的局限,都可能造成这种错误。即使基数估算正确,也不能保证成本估算完全准确,因为成本模型及其参数本身就是近似的;但基数是几乎所有后续规划决策的重要输入。
2.3.2 基数估算
基数估算是递归进行的。为了估算一个节点的基数,PostgreSQL 首先估算其各个子节点的基数,再根据当前节点的类型及其谓词,估算该节点自身会输出多少行。
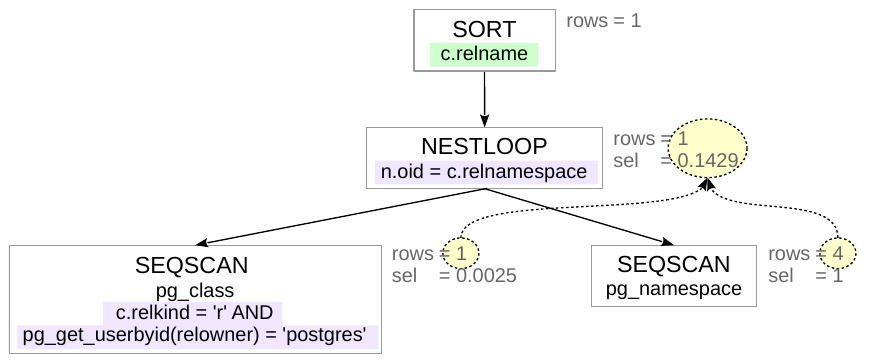
这个过程从读取数据的访问方法所在的叶节点开始。估算这些节点的基数,需要知道关系的大小及其谓词的选择率。后续章节会介绍这些估算值的来源。
暂且假设我们能够估算简单谓词的选择率,那么复合谓词的选择率就可以用下面的公式近似计算:
这些公式假设条件 x 和 y 相互独立。如果谓词之间存在相关性,估算就可能出错。PostgreSQL 的扩展统计信息能够改善其中一些情况。
接下来是连接。我们已经有了两个输入行集的基数估算,还需要估算连接条件的选择率。具体细节暂且放下,后面再结合实例讨论。
其他节点也可以采用类似的处理方式,例如聚合。排序通常不会改变基数,而其他操作可能会改变它。
在计划树底层引入的估算误差会向上传播。随着越来越多的操作依赖这个不准确的估算,误差的影响可能被放大,最终导致规划器选择一个不佳的计划。
2.3.3 成本估算
成本估算同样是递归进行的。为了估算一棵计划子树的成本,PostgreSQL 从各个子节点的成本出发,再加上当前节点所执行操作的成本。
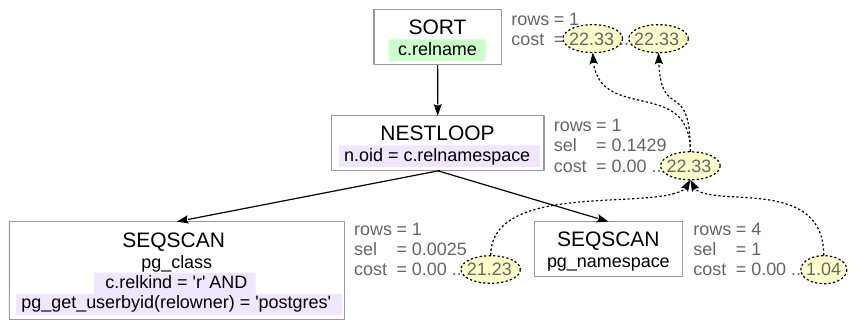
节点的成本由规划器的数学模型计算得出,模型使用该节点已经估算出的基数及其他特征。
EXPLAIN 显示两个成本分量:启动成本表示节点开始输出行之前,预计必须完成的工作量;总成本表示输出全部行的预计成本。
有些操作几乎不需要启动阶段的工作,甚至完全不需要。另一些操作则必须先完成大量工作,才能返回第一行。
例如,普通排序必须先接收完需要排序的输入,才能输出有序结果。这类节点的启动成本不为零;即使使用结果的一方只需要最终结果的一小部分,也必须付出这部分成本。
必须理解,成本反映的是规划器的估算,不一定与实际执行时间相关。成本可以看作以某种任意单位表示的数值,数值本身没有独立意义。它的作用仅仅是让规划器比较同一查询的不同计划。
2.3.4 选择最优计划
优化器力求在合理的规划时间内找到最优计划。
对于连接,PostgreSQL 通常使用动态规划,从较小的连接关系逐步构建更大的连接关系,同时淘汰那些按照规划器的选择标准不可能胜出的候选方案。随着关系数量增加,穷举连接顺序的成本会变得过高。PostgreSQL 可以通过只考虑部分两两连接的候选方案,或切换到遗传查询优化器 (GEQO),来减少需要考虑的计划数量。这也带来了计划不佳的另一种可能原因:成本估算并没有错,只是最优计划从未进入考虑范围。在这种情况下,查询编写者有时可以通过约束连接顺序来提供帮助。
什么样的计划才算“最优”?对于普通查询,PostgreSQL 通常以获取完整结果为优化目标,因此主要考虑总成本。
但对于游标,尽快获取前几行可能更重要。参数 cursor_tuple_fraction 告诉规划器,预计会从游标中获取多少比例的行。这个值越小,启动成本相对于总成本的影响就越大。
2.3.5 查看查询计划
EXPLAIN 用于显示查询计划。它是分析查询性能不可或缺的工具,学会准确解读其输出十分重要。下面是前面那条查询的执行计划:3
EXPLAIN SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;

                           QUERY PLAN
--------------------------------------------------------------
 Sort  (cost=22.36..22.37 rows=1 width=128)
   Sort Key: c.relname
   ->  Nested Loop Left Join
         (cost=0.00..22.35 rows=1 width=128)
         Join Filter: (n.oid = c.relnamespace)
         ->  Seq Scan on pg_class c
               (cost=0.00..21.26 rows=1 width=72)
               Filter: ((relkind = ANY ('{r,p}'::"char"[])) ...
         ->  Seq Scan on pg_namespace n
               (cost=0.00..1.04 rows=4 width=68)
(10 rows)
添加 analyze 选项后,PostgreSQL 会实际执行查询,同时显示估算值和实际执行统计信息:
EXPLAIN (analyze, buffers off) SELECT schemaname, tablename
FROM pg_tables
WHERE tableowner = 'postgres'
ORDER BY tablename;

                           QUERY PLAN
--------------------------------------------------------------
 Sort  (cost=22.36..22.37 rows=1 width=128)
   (actual time=0.101..0.103 rows=77.00 loops=1)
   Sort Key: c.relname
   Sort Method: quicksort  Memory: 35kB
   ->  Nested Loop Left Join
         (cost=0.00..22.35 rows=1 width=128)
         (actual time=0.009..0.080 rows=77.00 loops=1)
         Join Filter: (n.oid = c.relnamespace)
         Rows Removed by Join Filter: 112
         ->  Seq Scan on pg_class c
               (cost=0.00..21.26 rows=1 width=72)
               (actual time=0.006..0.039 rows=77.00 loops=1)
               Filter: ((relkind = ANY ('{r,p}'::"char"[])) ...
               Rows Removed by Filter: 382
         ->  Seq Scan on pg_namespace n
               (cost=0.00..1.04 rows=4 width=68)
               (actual time=0.000..0.000 rows=2.45 loops=77)
 Planning Time: 0.080 ms
 Execution Time: 0.113 ms
(19 rows)
对修改数据的语句使用 EXPLAIN ANALYZE 时要格外小心:语句会被实际执行。
在某些平台上,收集每个计划节点的计时信息会明显拖慢查询。如果不需要节点级别的计时信息,可以使用 timing off 将其关闭。