本章目录
第 9 章:调优方法
9.1 应当调优什么
性能是整个信息系统的属性,而不只是某一条 SQL 语句的属性。
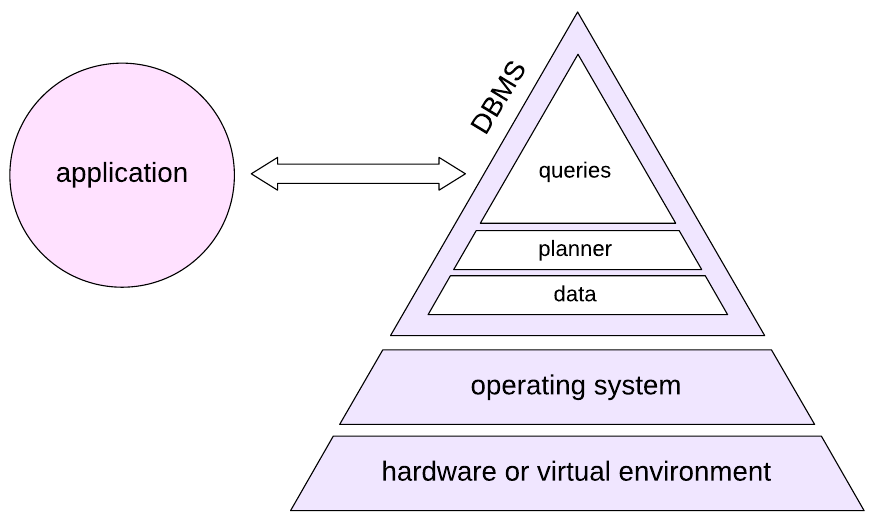
本书不打算详细讨论两个重要的底层:硬件和操作系统。PostgreSQL 最终通过操作系统和文件系统访问存储设备,而延迟、带宽、持久性特征、缓存层次、虚拟化层和存储拓扑都会影响数据库的行为。如果底层资源不足或配置不当,SQL 调优终究无法一直弥补这些问题。
在 PostgreSQL 服务器层面,我们的目标是合理分配资源,让维护工作正常进行,并使规划器对硬件和数据形成切合实际的认识。
在应用层面,连接管理、请求的组织方式、模式设计以及客户端与服务器之间的往返次数,可能与某个执行计划同样重要。
最后,还可以对单条查询进行性能剖析和调优。开发者往往从当前正在编写的查询入手;管理员通常从消耗系统资源最多的查询入手。第 7 章“性能剖析”已经说明,这两类查询并不总是一回事。
9.2 服务器调优
9.2.1 CPU 与 I/O 资源
并行查询使 PostgreSQL 能够使用多个 CPU 核心,执行计划中适合并行处理的部分。限制工作进程数量的主要参数如下:
- max_parallel_workers_per_gather
- max_parallel_workers
- max_worker_processes
这些参数规定的是上限,不是保证。计划可能请求了工作进程,但执行时没有足够的进程可用;工作进程也并非越多越好。每个并行工作进程都是实际的 PostgreSQL 进程,会消耗 CPU、内存和 I/O 带宽。使用后台进程进行应用开发的内容,见 DEV2 课程的“后台进程”一课。
I/O 有两项基本设置:能够并发执行的操作数量,以及单次操作能够读取的连续页面数量。前者由普通操作的 effective_io_concurrency 和维护操作的 maintenance_io_concurrency 控制,后者由 io_combine_limit 控制。
io_method 提供了几种异步 I/O 实现方式,此外还有一些更细的设置。调整这些参数时,需要考虑服务器 I/O 子系统的能力和工作负载的特征。
9.2.2 内存
work_mem 决定单个操作可使用的内存大小,前面相关章节已经讨论过。它也会影响计划的选择:取值较小时,规划器可能更倾向于排序而不是哈希,因为排序算法对内存不足不那么敏感。对于采用哈希的操作,可以通过 hash_mem_multiplier 提高内存上限。
maintenance_work_mem 会影响索引创建的速度以及维护进程的工作。
shared_buffers 决定缓冲区缓存的大小。
在 OLTP 数据库中,无论数据库有多大,通常都有一组相对集中的活跃数据。如果 shared_buffers 太小,这些数据就无法全部放入缓冲区缓存,页面会不断被逐出,从而增加 I/O 压力,尽管操作系统的页面缓存能够在一定程度上缓解这个问题。不过,缓冲区缓存也不宜过大,因为管理它的开销会随之增长。
因此,合适的缓冲区缓存大小取决于许多因素,没有一个适用于所有系统的 shared_buffers 取值公式。DBA2 课程会讨论这个参数的调优,不过有一点可以确定:它的默认值实在太小了。
effective_cache_size 告诉规划器,缓冲区缓存和操作系统缓存合计预计能为单条查询提供多大的有效缓存。该值越大,索引访问对规划器就越有吸引力。这个参数并不分配内存。
9.2.3 物理布局
即使 SQL 模式不变,数据的物理组织方式也可能影响性能。
表空间可以将指定的关系或索引放到不同的存储设备上。例如,可以将经常访问的数据放到 SSD 上,将归档数据放到较慢的 HDD 上。在确有必要时,还可以使用表空间级别的规划器参数,例如 random_page_cost 和 effective_io_concurrency,描述不同设备的特征。
分区使处理非常大的数据量成为可能。它在性能上的主要收益,是用扫描单个分区代替扫描整张表。分区还可以放在不同的表空间中。1
分片是另一种选择:可以将分区分散到不同的服务器上,并执行分布式查询。标准 PostgreSQL 只提供了搭建分片所需的基础机制:分区和 postgres_fdw 扩展。2 第三方方案对分片的实现更加高效、完整。DBA3 课程的最后一课会概述这个主题。
9.2.4 规划器统计信息
如第 6 章“统计信息”所述,规划器依靠统计信息进行估算。这意味着必须足够频繁地收集统计信息,可以通过调整 autovacuum 和自动分析的设置来控制。DBA2 课程会深入讨论这些细节。
统计信息还必须足够准确。绝对准确既做不到,也没有必要,但误差不能大到让规划器选择不合适的计划。叶子计划节点中,预估行数与实际行数相差悬殊,就是统计信息过时或不准确的一个信号。
为提高准确性,可能需要在全局或单个表列上调整统计信息目标。有时,表达式索引也能派上用场,因为它有自己的统计信息。在某些情况下,还可以使用扩展统计信息。
9.2.5 规划器成本模型
规划器的成本参数用于描述硬件和工作负载之间的相对关系,不是用来预测以毫秒计的实际耗时。
seq_page_cost 通常应当保持默认值不变。random_page_cost 较高的默认值反映了典型 HDD 的特征。对于 SSD,或者数据很可能已在缓存中的情况,应当显著降低这个值,例如降到 1.1。3
CPU 成本参数为处理已读入的数据定义了相应的权重。通常不调整这些参数,因为很难预测调整后的影响。不过,正如第 8 章“物化与函数”所示,有时需要以 cpu_operator_cost 为单位,指定用户自定义函数的成本。4
只有在具有代表性的查询中发现系统性的建模偏差时,才有理由调整成本参数,尤其是在基数估算已经比较准确的情况下。例如:
EXPLAIN (analyze, timing off, buffers off)
SELECT * FROM bookings
WHERE book_ref < 'E00000';

                  QUERY PLAN
----------------------------------------------
 Seq Scan on bookings
   (cost=0.00..46939.88 rows=994271 width=21)
   (actual rows=967421.00 loops=1)
   Filter: (book_ref < 'E00000'::bpchar)
   Rows Removed by Filter: 1519289
 Planning Time: 0.093 ms
 Execution Time: 101.680 ms
(7 rows)
行数估算比较准确。规划器掌握了足够的统计信息,并选择了顺序扫描。
为了诊断问题,可以暂时让规划器尽量避免顺序扫描。enable_* 这一类参数有意采用了比较粗粒度的控制方式:它们不会在所有情况下排除所有包含相应节点类型的计划,而是强烈抑制这些选择。
SET enable_seqscan = off; -- until the end of the session这类参数最适合用于实验:“PostgreSQL 认为次优的备选计划是什么?它实际执行起来又如何?”
现在,同一个查询采用了位图访问:
EXPLAIN (analyze, timing off, buffers off)
SELECT * FROM bookings
WHERE book_ref < 'E00000';

                    QUERY PLAN
--------------------------------------------------
 Bitmap Heap Scan on bookings
   (cost=18618.03..46902.42 rows=994271 width=21)
   (actual rows=967421.00 loops=1)
   Recheck Cond: (book_ref < 'E00000'::bpchar)
   Heap Blocks: exact=15839
   -> Bitmap Index Scan on bookings_pkey
       (cost=0.00..18369.46 rows=994271 width=0)
       (actual rows=967422.00 loops=1)
       Index Cond: (book_ref < 'E00000'::bpchar)
       Index Searches: 1
 Planning Time: 0.044 ms
 Execution Time: 88.419 ms
(12 rows)

RESET enable_seqscan;
结果很可能表明,索引访问更有优势,因为全部数据都已缓存,随机访问很快。使用高速 SSD 时也可能出现类似情况。
不能仅凭一条查询就得出结论。但如果这种偏差反复出现,就有理由检查全局设置。此时,可以尝试降低 random_page_cost,使规划器不再高估索引访问的成本;也可以提高 effective_cache_size,使索引扫描更有吸引力。
9.3 应用调优
9.3.1 客户端与连接
建立数据库连接并非没有成本。PostgreSQL 的后端是一个进程,其内存占用和调度开销不容忽视。频繁创建大量短连接的应用,通常能从连接池中获益。不过,连接池也会给应用带来一些限制。DEV2 课程会讨论这个主题。
当应用确实只需要结果的开头一部分,或者逐步消费结果时,游标很有用。cursor_tuple_fraction 告诉规划器,预计会提取游标结果中的多大比例,这可能改变启动成本与总成本之间的权衡。
另一类常见的性能问题,不是一条很慢的 SQL,而是成千上万条各自都很快的 SQL。例如,ORM 的 N + 1 查询就可能产生这种模式。第 7 章“性能剖析”中,我们已经见过一个类似的例子:在循环中调用函数。
遇到这种情况,数据库服务器几乎无从优化,预备语句是个例外,它可以减少重复查询的开销。
有效的做法是去掉应用中的过程式代码,将这些工作交给数据库服务器,用少量较大的 SQL 命令完成。这样,规划器就有机会使用更高效的访问方法和连接方法,也避免了客户端与服务器之间的大量数据传输。遗憾的是,这种改动的代价可能很高。
9.3.2 数据模型
在逻辑层面,数据库应当规范化。通俗地说,就是存储的数据不应冗余。否则就是设计上的问题,因为数据一致性难以检查,还可能出现各种更新异常。
在存储层面,出于性能考虑,有时可以有意引入冗余,前提是系统有明确的机制,保证冗余数据的一致性。
索引是最常见的例子:它在另一个物理结构中保存了表内信息的副本,并由 PostgreSQL 自动维护。
其他形式还包括生成列、由触发器维护的值以及物化视图。应用也可以通过缓存查询结果来复制数据。这是一种常用手段,但很多时候,采用它是因为应用没有妥善使用数据库,例如通过 ORM 访问数据库。这样一来,应用就必须负责及时更新缓存、控制缓存数据的访问权限,以及处理相关的一致性问题。
选择合适的数据类型也是查询优化的一部分。例如,使用 PostgreSQL 的范围类型 daterange 或 tstzrange 表示区间,可以直接表达区间语义,并针对重叠等操作使用 GiST 或 SP-GiST 索引。
数组和 JSON 有时可以避免连接,并减少元组头的开销,但也会改变约束、统计信息、更新粒度、索引以及查询语义。使用复杂类型应当是因为它适合数据模型,而不只是为了避免一次连接。
完整性约束首先用于保证正确性。同时,它们也可以为规划器提供有用的保证:
- 主键和唯一约束带有唯一索引,保证键值组合的唯一性,为估算提供准确的唯一性信息。这些保证也能让连接更高效。
- 外键配合 NOT NULL 约束,在某些情况下可为消除不必要的连接提供依据,这对视图尤其重要;当连接涉及多列时,外键还可以改善选择率估算。
- CHECK 约束配合 constraint_exclusion 参数,可以避免扫描那些确定不含所需数据的表或分区。
下面是一个复合键连接的例子,基数估算比较准确:
EXPLAIN SELECT * FROM segments s
  JOIN boarding_passes bp ON s.flight_id = bp.flight_id
                         AND s.ticket_no = bp.ticket_no;

                         QUERY PLAN
------------------------------------------------------------
 Hash Join  (cost=275309.45..625075.75 rows=5982418 widt...
   Hash Cond: ((s.flight_id = bp.flight_id) AND (s.ticke...
   -> Seq Scan on segments s
       (cost=0.00..134750.62 rows=7349462 width=31)
   -> Hash  (cost=109624.18..109624.18 rows=5982418 widt...
       -> Seq Scan on boarding_passes bp
           (cost=0.00..109624.18 rows=5982418 width=80)
(7 rows)
然而,如果删除外键,估算就会变得很不合理。这也是谓词相关性问题的另一种表现:
BEGIN;
ALTER TABLE boarding_passes
DROP CONSTRAINT boarding_passes_ticket_no_flight_id_fkey;
EXPLAIN SELECT * FROM segments s
  JOIN boarding_passes bp ON s.flight_id = bp.flight_id
                         AND s.ticket_no = bp.ticket_no;

                         QUERY PLAN
------------------------------------------------------------
 Hash Join  (cost=275309.45..625075.75 rows=504 width=111)
   Hash Cond: ((s.flight_id = bp.flight_id) AND (s.ticke...
   -> Seq Scan on segments s
       (cost=0.00..134750.62 rows=7349462 width=31)
   -> Hash  (cost=109624.18..109624.18 rows=5982418 widt...
       -> Seq Scan on boarding_passes bp
           (cost=0.00..109624.18 rows=5982418 width=80)
(7 rows)

ROLLBACK;
9.4 查询
9.4.1 优化的途径
查询调优的直接目标,是得到合适的执行计划,但达到这个目标有不同的途径。
一种是直接干预:检查不合适的计划,找出其中不合理的选择,强制或引导规划器采用另一种方案。遗憾的是,问题所在并不总是一目了然,调优常常变成与规划器的较量。沿着这条路走下去,你会希望能够完全或部分关闭规划器,自己构造执行计划。这种功能称为 hint,PostgreSQL 并没有显式提供它。
另一种是查明原因:弄清规划器为什么认为这个不合适的计划成本很低。修正基数估算、统计信息、表达式和成本假设,让规划器自行选择更好的计划。
第二种方法更稳健,因为当数据和条件变化时,规划器仍然保留选择的自由,但这并不总是容易做到。有时,生产故障需要先用一种临时方案缓解。
两种方法都有用。区别在于,你是在改善规划器掌握的信息,还是在限制它的选择。
9.4.2 短查询
这里的“短”和“长”只是便于讨论的分类,不是 PostgreSQL 的正式概念。
短查询通常出现在对延迟敏感的 OLTP 工作负载中:读取少量数据,并且通常只返回几行。它可能访问非常大的表,但谓词通常具有很强的筛选能力,只有很小一部分输入行满足条件。
短查询通常服务于用户界面,因此应当尽可能快地执行,响应时间优先。
典型的高效执行方式包括:扫描很小的关系;在大关系中通过索引查找;采用嵌套循环,对内集合进行成本很低的参数化查找。
连接通常使用嵌套循环。与哈希连接不同,它不需要预备工作,在参与连接的行数很少时表现良好。来看一个查询,返回预订时间落在某个小时内的机票。 这个短查询示例禁用了并行执行,因为这里用不上它:
SET max_parallel_workers_per_gather = 0;
EXPLAIN (analyze, timing off)
SELECT t.*
FROM bookings b
JOIN tickets t ON t.book_ref = b.book_ref
WHERE date_trunc('hour', b.book_date) =
      '2025-11-01 12:00:00+03';

                         QUERY PLAN
------------------------------------------------------------
 Hash Join  (cost=53312.08..181808.82 rows=27993 width=52)
   (actual rows=1338.00 loops=1)
   Hash Cond: (t.book_ref = b.book_ref)
   Buffers: shared hit=12738 read=60934
   -> Seq Scan on tickets t
       (cost=0.00..113800.73 rows=5598473 width=52)
       (actual rows=5598473.00 loops=1)
       Buffers: shared read=57816
   -> Hash  (cost=53156.65..53156.65 rows=12434 width=7)
       (actual rows=567.00 loops=1)
       Buckets: 16384  Batches: 1  Memory Usage: 150kB
       Buffers: shared hit=12738 read=3118
       -> Seq Scan on bookings b
           (cost=0.00..53156.65 rows=12434 width=7)
           (actual rows=567.00 loops=1)
           Filter: (date_trunc('hour'::text, book_date) ...
           Rows Removed by Filter: 2486143
           Buffers: shared hit=12738 read=3118
 Planning:
   Buffers: shared hit=172 read=18
 Planning Time: 0.704 ms
 Execution Time: 380.957 ms
(22 rows)
这是一个短查询:两个大表中需要的数据都远不到各自的 1%。然而,两个表都被完整扫描,预估基数也与实际值相差很大。
先看最内层 bookings 上的 Seq Scan。问题在于 date_trunc:它没有规划器支持函数,因此 PostgreSQL 使用了固定的 0.5% 选择率估算。
EXPLAIN (analyze, timing off, buffers off, summary off)
SELECT * FROM bookings b
WHERE b.book_date >= '2025-11-01 12:00:00+03'
  AND b.book_date  < '2025-11-01 13:00:00+03';

                         QUERY PLAN
------------------------------------------------------------
 Seq Scan on bookings b
   (cost=0.00..53156.65 rows=546 width=21)
   (actual rows=567.00 loops=1)
   Filter: ((book_date >= '2025-11-01 12:00:00+03'::time...
   Rows Removed by Filter: 2486143
(5 rows)
现在,估算已经接近实际,但 PostgreSQL 仍然没有能够避免全表扫描的访问路径。创建一个索引:
CREATE INDEX ON bookings(book_date);
EXPLAIN (analyze, timing off)
SELECT t.* FROM bookings b
JOIN tickets t ON t.book_ref = b.book_ref
WHERE b.book_date >= '2025-11-01 12:00:00+03'
  AND b.book_date  < '2025-11-01 13:00:00+03';

                         QUERY PLAN
------------------------------------------------------------
 Nested Loop  (cost=0.99..13265.14 rows=1229 width=52) (...
   Buffers: shared hit=2630 read=782
   -> Index Scan using bookings_book_date_idx on booking...
       Index Cond: ((book_date >= '2025-11-01 12:00:00+0...
       Index Searches: 1
       Buffers: shared hit=542 read=5
   -> Index Scan using tickets_book_ref_passenger_id_out...
       Index Cond: (book_ref = b.book_ref)
       Index Searches: 567
       Buffers: shared hit=2088 read=777
 Planning:
   Buffers: shared hit=46 read=1
 Planning Time: 0.153 ms
 Execution Time: 128.876 ms
(14 rows)
这正是我们想要的:规划器选择了索引扫描,数据通过嵌套循环连接。
还可以进一步改进:只扫描索引,完全不访问 bookings 表。将连接键包含在索引中,就能使第一次查找所需的列全部由这个覆盖索引提供:
DROP INDEX bookings_book_date_idx;
CREATE INDEX ON bookings(book_date) INCLUDE (book_ref);
EXPLAIN (analyze, timing off)
SELECT t.*
FROM bookings b
JOIN tickets t ON t.book_ref = b.book_ref
WHERE b.book_date >= '2025-11-01 12:00:00+03'
  AND b.book_date  < '2025-11-01 13:00:00+03';

                         QUERY PLAN
------------------------------------------------------------
 Nested Loop  (cost=0.99..13246.54 rows=1229 width=52) (...
   Buffers: shared hit=2866 read=6
   -> Index Only Scan using bookings_book_date_book_ref_...
       Index Cond: ((book_date >= '2025-11-01 12:00:00+0...
       Heap Fetches: 0
       Index Searches: 1
       Buffers: shared hit=1 read=6
   -> Index Scan using tickets_book_ref_passenger_id_out...
       Index Cond: (book_ref = b.book_ref)
       Index Searches: 567
       Buffers: shared hit=2865
 Planning:
   Buffers: shared hit=42 read=1
 Planning Time: 0.171 ms
 Execution Time: 2.089 ms
(15 rows)
这又减少了大约 15% 的逻辑缓冲区访问。 PostgreSQL 现在能够对 bookings 使用仅索引扫描。索引中这些额外存储的列值,是否值得付出相应的维护和存储成本,取决于这种访问模式出现的频率。对于很少执行的查询,仅仅为了节省几次缓冲区访问而做的微小优化,可能并不划算。
9.4.3 长查询
长查询是指以吞吐量为重、必须处理大量数据才能得到答案的查询。即使聚合后只返回一行,长查询仍可能读取数百万行。
这类查询的谓词通常筛选能力较弱,大量输入行都能通过。因此,全表扫描和哈希连接更有吸引力,总体吞吐量也比立即返回第一行更重要。
同样,这些只是倾向,不是规则。长查询的计划也可能针对某个维度,使用筛选能力很强的索引查找,或者对确实很小的输入使用嵌套循环。最需要警惕的是重复工作:相关子查询、隐藏的函数调用,或者不合适的嵌套循环计划,都可能使同一个大数据集被反复读取。
长查询处理的数据很多,通常还要聚合,因为用户很少需要数百万行结果。因此,它们可以从并行执行中获益。
来看这个查询:统计起飞和到达都延误了 1 分钟至 4 小时的航班所承运的旅客人次。
\timing on
SELECT count(*)
FROM flights f
  JOIN segments tf ON tf.flight_id = f.flight_id
  JOIN boarding_passes bp ON bp.flight_id = tf.flight_id
                         AND bp.ticket_no = tf.ticket_no
WHERE f.actual_departure - f.scheduled_departure
        BETWEEN interval '1 min' AND interval '4 hours'
  AND f.actual_arrival - f.scheduled_arrival
        BETWEEN interval '1 min' AND interval '4 hours';

  count
---------
 5871849
(1 row)
Time: 26956.143 ms (00:26.956)

\timing off
查询返回了正确的结果,但执行时间不能令人满意。
先明确问题的规模。flights 表的总行数如下:
SELECT count(*)
FROM flights f;

 count
-------
 37671
(1 row)
这些谓词保留了相当多的行:
SELECT count(*) FROM flights f
WHERE f.actual_departure - f.scheduled_departure
        BETWEEN interval '1 min' AND interval '4 hours'
  AND f.actual_arrival - f.scheduled_arrival
        BETWEEN interval '1 min' AND interval '4 hours';

 count
-------
 26364
(1 row)
约 70% 的航班满足条件。参与连接的其他表都很大,也没有筛选能力很强的限制条件。
显然,这是一个长查询,但计划看起来却像是只查找少量数据的 OLTP 查询:
                         QUERY PLAN
------------------------------------------------------------
 Aggregate  (cost=1713.52..1713.53 rows=1 width=8)
   -> Nested Loop
       (cost=0.86..1713.12 rows=159 width=0)
       -> Nested Loop
           (cost=0.43..1626.77 rows=195 width=22)
           -> Seq Scan on flights f
               (cost=0.00..1498.13 rows=1 width=4)
               Filter: (((actual_departure - scheduled_d...
           -> Index Scan using segments_flight_id_idx on...
               (cost=0.43..125.95 rows=269 width=18)
               Index Cond: (flight_id = f.flight_id)
       -> Index Only Scan using boarding_passes_pkey on ...
           (cost=0.43..1.99 rows=150 width=36)
           Index Cond: ((ticket_no = tf.ticket_no) AND (...
(14 rows)
核心问题一目了然:规划器估计只有一个航班符合条件,而不是实际的两万六千多个。基于这样的估算,嵌套循环和索引查找看起来完全合理。
做一个诊断实验,让规划器尽量避免嵌套循环:
SET enable_nestloop = off;
SET
现在再执行 EXPLAIN:
EXPLAIN (analyze, timing off, costs off)
SELECT count(*)
FROM flights f
  JOIN segments tf ON tf.flight_id = f.flight_id
  JOIN boarding_passes bp ON bp.flight_id = tf.flight_id
                         AND bp.ticket_no = tf.ticket_no
WHERE f.actual_departure - f.scheduled_departure
        BETWEEN interval '1 min' AND interval '4 hours'
  AND f.actual_arrival - f.scheduled_arrival
        BETWEEN interval '1 min' AND interval '4 hours';

                         QUERY PLAN
------------------------------------------------------------
 Aggregate (actual rows=1.00 loops=1)
   Buffers: shared hit=11393 read=100031, temp read=8496...
   -> Hash Join (actual rows=5871849.00 loops=1)
       Hash Cond: ((bp.flight_id = tf.flight_id) AND (bp...
       Buffers: shared hit=11393 read=100031, temp read=...
       -> Seq Scan on boarding_passes bp (actual rows=59...
           Buffers: shared hit=2632 read=47168
       -> Hash (actual rows=5871849.00 loops=1)
           Buckets: 262144 (originally 1024)  Batches: 6...
           Buffers: shared hit=8761 read=52863, temp wri...
           -> Hash Join (actual rows=5871849.00 loops=1)
               Hash Cond: (tf.flight_id = f.flight_id)
               Buffers: shared hit=8761 read=52863
               -> Seq Scan on segments tf (actual rows=7...
                   Buffers: shared hit=8393 read=52863
               -> Hash (actual rows=26364.00 loops=1)
                   Buckets: 32768 (originally 1024)  Bat...
                   Buffers: shared hit=368
                   -> Seq Scan on flights f (actual rows...
                       Filter: (((actual_departure - sch...
                       Rows Removed by Filter: 11307
                       Buffers: shared hit=368
 Planning:
   Buffers: shared hit=14
 Planning Time: 0.117 ms
 Execution Time: 2756.711 ms
(26 rows)

RESET enable_nestloop;
表的访问方式自动改成了顺序扫描,查询也更快了。如果使用 buffers 选项检查计划,可以看到这个查询需要读取约 110,000 个页面。我们没有展示第一个版本带 buffers 的执行计划,但它读取的数据量几乎是这里的 200 倍,你可以自己检查一下!
性能的大幅改善验证了诊断,但为什么选择率会估算得这么差?两个谓词都对时间戳列使用了算术表达式,而规划器没有这些表达式的分布统计信息。按照第 6 章“统计信息”介绍的方法,收集表达式统计信息:
CREATE STATISTICS
ON (actual_departure - scheduled_departure) FROM flights;
CREATE STATISTICS
ON (actual_arrival - scheduled_arrival) FROM flights;
ANALYZE flights;
EXPLAIN SELECT count(*)
FROM flights f
  JOIN segments tf ON tf.flight_id = f.flight_id
  JOIN boarding_passes bp ON bp.flight_id = tf.flight_id
                         AND bp.ticket_no = tf.ticket_no
WHERE f.actual_departure - f.scheduled_departure
        BETWEEN interval '1 min' AND interval '4 hours'
  AND f.actual_arrival - f.scheduled_arrival
        BETWEEN interval '1 min' AND interval '4 hours';

                         QUERY PLAN
------------------------------------------------------------
 Aggregate  (cost=517827.35..517827.36 rows=1 width=8)
   -> Hash Join
       (cost=247829.93..510415.83 rows=2964608 width=0)
       Hash Cond: ((tf.flight_id = bp.flight_id) AND (tf...
       -> Hash Join
           (cost=1731.48..155776.61 rows=3642052 width=22)
           Hash Cond: (tf.flight_id = f.flight_id)
           -> Seq Scan on segments tf
               (cost=0.00..134750.62 rows=7349462 width=18)
           -> Hash
               (cost=1498.13..1498.13 rows=18668 width=4)
               -> Seq Scan on flights f
                   (cost=0.00..1498.13 rows=18668 width=4)
                   Filter: (((actual_departure - schedul...
       -> Hash
           (cost=109624.18..109624.18 rows=5982418 width...
           -> Seq Scan on boarding_passes bp
               (cost=0.00..109624.18 rows=5982418 width=36)
(18 rows)现在,规划器估计会有更多航班满足条件,不用强制干预就选择了哈希连接。不过,收集统计信息并不是优化的终点。还要问一个问题:我们是否读取了超出实际需要的数据?
在这个模式中,boarding_passes 已经包含 flight_id,外键关系也保证了得到结果所需的数据完整性。连接 segments 并没有在这个查询中额外过滤任何行,因此可以直接连接 flights 和 boarding_passes。
EXPLAIN (analyze, timing off)
SELECT count(*)
FROM flights f
  JOIN boarding_passes bp ON bp.flight_id = f.flight_id
WHERE f.actual_departure - f.scheduled_departure
        BETWEEN interval '1 min' AND interval '4 hours'
  AND f.actual_arrival - f.scheduled_arrival
        BETWEEN interval '1 min' AND interval '4 hours';

                         QUERY PLAN
------------------------------------------------------------
 Aggregate  (cost=134472.80..134472.81 rows=1 width=8) (...
   Buffers: shared hit=3094 read=47074
   -> Hash Join  (cost=1731.48..127061.28 rows=2964609 w...
       Hash Cond: (bp.flight_id = f.flight_id)
       Buffers: shared hit=3094 read=47074
       -> Seq Scan on boarding_passes bp  (cost=0.00..10...
           Buffers: shared hit=2726 read=47074
       -> Hash  (cost=1498.13..1498.13 rows=18668 width=...
           Buckets: 32768  Batches: 1  Memory Usage: 1183kB
           Buffers: shared hit=368
           -> Seq Scan on flights f  (cost=0.00..1498.13...
               Filter: (((actual_departure - scheduled_d...
               Rows Removed by Filter: 11307
               Buffers: shared hit=368
 Planning Time: 0.067 ms
 Execution Time: 465.082 ms
(16 rows)
这两个堆关系包含的页面数量如下:
SELECT sum(relpages) FROM pg_class
WHERE relname IN ('flights','boarding_passes');

  sum
-------
 50168
(1 row)
从 buffers 选项可以看到,这个版本读取的数据量大致就是参与查询的关系本身所占的大小。第一个版本没有展示 buffers,不过你可以检查,它读取的数据量几乎是这个版本的 200 倍。
总的来说,查询改写是影响性能的手段中变化最丰富的一种。规划器自己能够做一些等价变换,而我们还可以,例如:
- 改写条件,使其能够使用索引,或者反过来,使其不能使用索引。
- 将本质上采用嵌套循环的相关子查询改写为连接。
- 消除多余的扫描,如本例所示,或者通过窗口函数实现。
- 采用规划器尚不能完成的变换,例如用 UNION 替换 OR 条件。
示例完成后,清理实验对象:
DROP INDEX bookings_book_date_book_ref_idx;
DROP INDEX
SELECT 'DROP STATISTICS ' || statistics_name
FROM pg_stats_ext \gexec
DROP STATISTICS
DROP STATISTICS
9.4.4 规划器 advice 与 hint
PostgreSQL 18 的核心没有提供 SQL hint 语法,不能在查询文本中直接指定某种连接顺序、扫描方式或连接方法。熟悉的 enable_* 设置适合作为粗粒度的诊断手段;显式的 JOIN 结构配合 join_collapse_limit,在某些情况下也可以限制连接顺序的搜索,但它们都不是通用的 hint 语言。
PostgreSQL 19 包含 pg_plan_advice 模块,可以描述并约束规划器的部分决策;还有 pg_stash_advice,可以将这些 advice 与查询标识符关联起来,而无须修改应用的 SQL 文本。5
第三方扩展早已提供了 hint 机制。最初由 Kyotaro Horiguchi 开发的 pg_hint_plan,就是一个广为人知的例子。6
当规划器反复作出已知的不合理选择,而且限制其选择的风险已经明确时,hint 和 plan advice 是有价值的工具。但如果只是用它们掩盖尚未查明原因的基数估算或成本模型问题,就没有那么可取。hint 会固定某个决策;良好的统计信息和合理的模型,则能保留规划器适应变化的能力。