本章目录
第 8 章:物化与函数
8.1 物化
物化是指保存一个中间行集,以便再次使用,通常会使用多次。保存结果的作用范围可以不同:在一次查询内部、在一个会话中,或者作为数据库对象保存。
大多数执行器节点以流水线方式工作。父节点向子节点请求下一行,请求沿计划树向下传递。不过,有些操作需要保存输入,以便反复读取。PostgreSQL 为此使用 Materialize 节点。
只要物化后的行集能够放入该操作可用的内存额度中,就会保存在后端进程的本地内存里。如果超过这一额度,PostgreSQL 就会使用临时存储。temp_file_limit 限制单个 PostgreSQL 进程使用的临时文件空间,也适用于同一客户端会话中参与执行的各个并行工作进程。
下图中,上层 Nested Loop 无法通过高效的参数化访问获取内集合,而这个内集合本身又是另一个操作的结果。
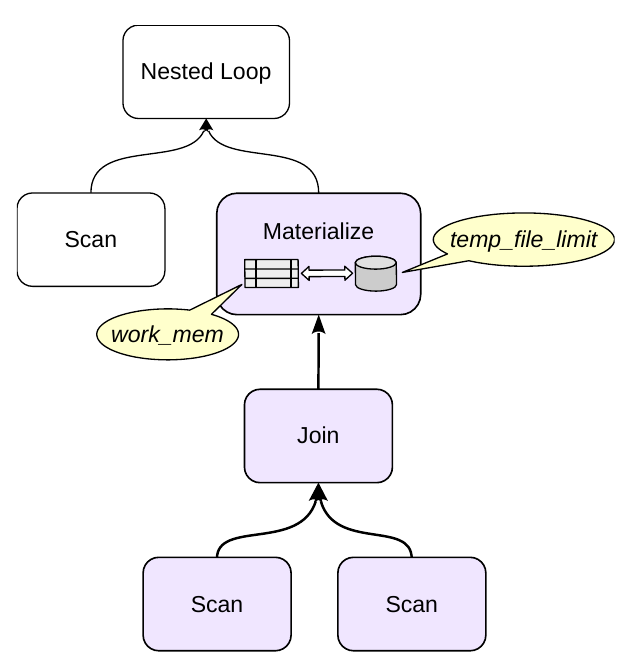
如果对外集合的每一行都重新计算一次内集合,就会造成浪费。因此,PostgreSQL 可以将其物化一次,再反复扫描保存的行。
例如,查找这样的机场对:一个机场使用莫斯科时间,另一个位于北极圈以北。
EXPLAIN (costs off)
SELECT a1.city, a2.city
FROM airports a1, airports a2
WHERE a1.timezone = 'Europe/Moscow'
  AND abs(a2.coordinates[1]) > 66.652;

                         QUERY PLAN
------------------------------------------------------------
 Nested Loop
   -> Seq Scan on airports_data ml_1
       Filter: (abs(coordinates[1]) > '66.652'::double p...
   -> Materialize
       -> Seq Scan on airports_data ml
           Filter: (timezone = 'Europe/Moscow'::text)
(6 rows)
本例中,没有可用于内集合谓词的有效索引。复用这个很小的内集合结果,比针对外集合的每一行都重新扫描和过滤成本更低。
8.1.1 CTE 物化
公用表表达式 (CTE),也称为 WITH 子查询,是组织查询结构、改善可读性的一种好方法。与普通子查询不同,使用 CTE 不会导致很深的嵌套。1
只要条件允许,规划器就会将 CTE 折叠进父查询,而不是物化它。这样,规划器就可以选择最优的连接顺序。
默认情况下,以下情形中的 CTE 会被物化:
- 主查询多次引用这个 CTE,因此其结果无须重复计算。这种情况下,可以通过 AS NOT MATERIALIZED 禁用物化。
- CTE 有副作用,包括修改数据或调用 VOLATILE 函数,这种情况下不能禁用物化。其中,修改数据的 CTE 会完整执行一次;SELECT CTE 则通常按父查询的需要求值。
总可以通过 AS MATERIALIZED 强制物化。
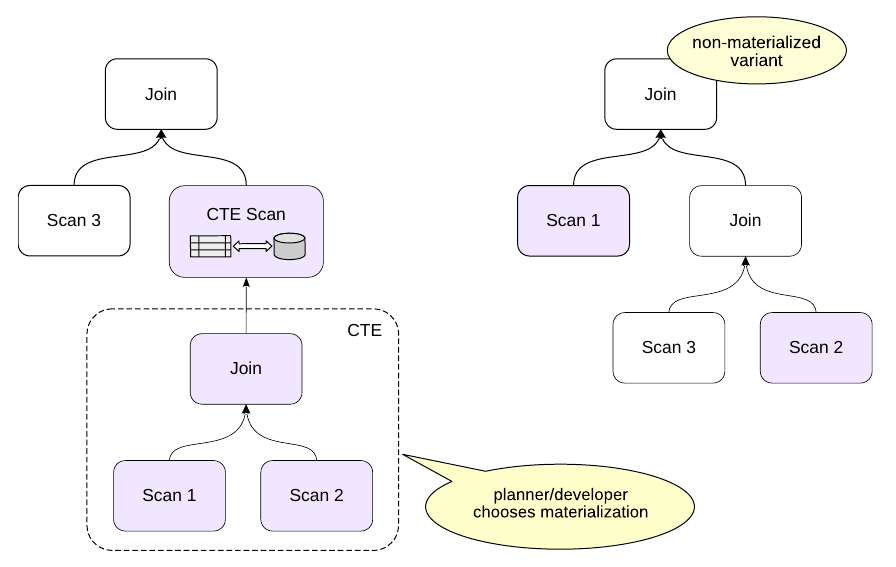
来看一个只使用一次的 CTE:
EXPLAIN (costs off)
WITH q AS (
  SELECT r.route_no, a.airplane_code
  FROM routes r
    JOIN airplanes a ON a.airplane_code = r.airplane_code
)
SELECT *
FROM q
  JOIN seats s ON s.airplane_code = q.airplane_code
WHERE s.seat_no = '1A';

                      QUERY PLAN
-------------------------------------------------------
 Hash Join
   Hash Cond: (ml.airplane_code = s.airplane_code)
   -> Hash Join
       Hash Cond: (r.airplane_code = ml.airplane_code)
       -> Seq Scan on routes r
       -> Hash
           -> Seq Scan on airplanes_data ml
   -> Hash
       -> Seq Scan on seats s
           Filter: (seat_no = '1A'::text)
(10 rows)
计划中没有 CTE Scan:CTE 已经直接折叠进主查询。
强制物化:
EXPLAIN (costs off)
WITH q AS MATERIALIZED (
  SELECT r.route_no, a.airplane_code
  FROM routes r
    JOIN airplanes a ON a.airplane_code = r.airplane_code
)
SELECT *
FROM q
  JOIN seats s ON s.airplane_code = q.airplane_code
WHERE s.seat_no = '1A';

                       QUERY PLAN
---------------------------------------------------------
 Hash Join
   Hash Cond: (q.airplane_code = s.airplane_code)
   CTE q
     -> Hash Join
         Hash Cond: (r.airplane_code = ml.airplane_code)
         -> Seq Scan on routes r
         -> Hash
             -> Seq Scan on airplanes_data ml
   -> CTE Scan on q
   -> Hash
       -> Seq Scan on seats s
           Filter: (seat_no = '1A'::text)
(12 rows)
现在,CTE 作为独立单元生成计划,父查询通过 CTE Scan 读取其结果。如果一个计算成本很高的结果会被重复使用,物化通常是不错的选择。但如果父查询只需要一个大型 CTE 结果中的极小部分,物化的代价就可能非常高。
例如:
EXPLAIN (analyze, costs off, buffers)
WITH b AS (
  SELECT * FROM bookings
)
SELECT *
FROM b AS b1
  JOIN b AS b2 ON b1.book_ref = b2.book_ref
WHERE b2.book_ref = '000112';

                         QUERY PLAN
------------------------------------------------------------
 Nested Loop (actual time=228.999..229.000 rows=0.00 loo...
   Buffers: shared read=15856, temp written=9746
   CTE b
     -> Seq Scan on bookings (actual time=0.064..71.089 ...
         Buffers: shared read=15856
   -> CTE Scan on b b1 (actual time=228.999..228.999 row...
       Filter: (book_ref = '000112'::bpchar)
       Rows Removed by Filter: 2486710
       Storage: Disk  Maximum Storage: 77968kB
       Buffers: shared read=15856, temp written=9746
   -> CTE Scan on b b2 (never executed)
       Filter: (book_ref = '000112'::bpchar)
       Storage: Disk  Maximum Storage: 77968kB
 Planning:
   Buffers: shared hit=23 read=1
 Planning Time: 0.106 ms
 Execution Time: 232.733 ms
(17 rows)
父查询只查找一个键,却物化了整张 bookings 表。现在允许对这个 CTE 的两次引用分别进行优化:
EXPLAIN (analyze, costs off, buffers)
WITH b AS NOT MATERIALIZED (
  SELECT * FROM bookings
)
SELECT *
FROM b AS b1
  JOIN b AS b2 ON b1.book_ref = b2.book_ref
WHERE b2.book_ref = '000112';

                         QUERY PLAN
------------------------------------------------------------
 Nested Loop (actual time=0.020..0.020 rows=0.00 loops=1)
   Buffers: shared read=3
   -> Index Scan using bookings_pkey on bookings (actual...
       Index Cond: (book_ref = '000112'::bpchar)
       Index Searches: 1
       Buffers: shared read=3
   -> Index Scan using bookings_pkey on bookings booking...
       Index Cond: (book_ref = '000112'::bpchar)
       Index Searches: 0
 Planning:
   Buffers: shared hit=5
 Planning Time: 0.075 ms
 Execution Time: 0.028 ms
(13 rows)
规划器现在可以将键上的限制条件下推到两次扫描中,并使用主键索引。可以对比这一方案与前一个方案的 Buffers 值。
不过,如果 CTE 修改数据,无论如何都会物化:修改必须恰好执行一次。
8.1.2 临时表
如果数据需要由多条查询复用,就不能通过一个 CTE 为这些查询统一计算,但可以将数据放入临时表,再由这些查询使用。临时表具有几个有用的性质:2
- 属于一个会话。
- ON COMMIT 可以在事务结束时保留行、删除行,或者删除整张表。
- 表中的数据不按普通表的方式记录 WAL。
- 使用后端进程的本地缓冲区,而不是共享缓冲区。
这些性质并不意味着临时表没有成本。PostgreSQL 仍然需要创建系统目录条目和关系文件。
如果工作负载以很高的频率创建和删除临时表,就可能给系统目录和文件系统带来压力。历史上,有些应用生态采用过 PostgreSQL 补丁或专门的设计来减少这类开销。这是针对具体应用的工程问题,不能据此笼统地认为应当避免使用临时表。
temp_buffers 限制一个会话可用于临时关系的本地缓冲区内存。只有在会话首次访问临时表之前,才能更改它的值。
创建一张包含北半球机场的临时表:
CREATE TEMP TABLE airports_nh -- Northern Hemisphere
ON COMMIT PRESERVE ROWS -- default
AS SELECT *
FROM airports
WHERE coordinates[1] > 0;
SELECT 4328
这张表创建在临时模式中,可以通过 pg_temp 访问。
对刚填充完的临时表,在用于查询之前执行分析通常是有意义的。后端进程的本地内存不能由 autovacuum 进程访问,因此临时表的清理和分析必须手动执行。
对比分析前后的基数估算:
EXPLAIN SELECT *
FROM airports_nh;

                QUERY PLAN
------------------------------------------
 Seq Scan on airports_nh
   (cost=0.00..91.52 rows=2752 width=160)
(2 rows)

ANALYZE airports_nh;
EXPLAIN SELECT *
FROM airports_nh;

                QUERY PLAN
------------------------------------------
 Seq Scan on airports_nh
   (cost=0.00..107.28 rows=4328 width=63)
(2 rows)
8.1.3 物化视图
物化视图是以数据库关系形式存储、具有名称的查询结果。可以像查询普通的只读表一样查询它。3
物化视图上可以创建索引,但不能添加完整性约束;约束必须在基表上检查。PostgreSQL 也会为物化视图收集规划器统计信息。
与普通视图不同,基表变化时,物化视图中的行不会随之变化,必须显式刷新。
全量刷新的成本可能很高。PostgreSQL 核心目前不会在基表变化时,逐行增量维护物化视图。Yugo Nagata 开发的 pg_ivm 扩展,在它所支持的场景中实现了增量视图维护。4
基于 airports 创建物化视图:
CREATE MATERIALIZED VIEW airports_mv AS
SELECT * FROM airports;
SELECT 5501
创建索引:
CREATE UNIQUE INDEX ON airports_mv(airport_code);
EXPLAIN (costs off) SELECT *
FROM airports_mv
ORDER BY airport_code
LIMIT 3;

                         QUERY PLAN
------------------------------------------------------------
 Limit
   -> Index Scan using airports_mv_airport_code_idx on a...
(2 rows)
现在修改一个基表中的值。2025 年 8 月,玛纳斯国际机场的 IATA 代码从 FRU 改为 BSZ;我们可以利用示例数据库中的这项信息来演示。
UPDATE airports_data
SET airport_code = 'BSZ'
WHERE airport_code = 'FRU';
UPDATE 1

SELECT count(*)
FROM airports_mv
WHERE airport_code = 'BSZ';

 count
-------
     0
(1 row)
物化视图中保存的行没有变化。同步必须显式进行,刷新这个物化视图:
REFRESH MATERIALIZED VIEW CONCURRENTLY airports_mv;
SELECT count(*) FROM airports_mv
WHERE airport_code = 'BSZ';

 count
-------
     1
(1 row)
8.2 函数
8.2.1 稳定性类别
每个函数都有一个稳定性类别。这一类别是向优化器作出的、关于函数行为的承诺。5
VOLATILE 是默认类别。对于相同的参数,VOLATILE 函数在连续调用时可能返回不同结果,也可能产生副作用。PostgreSQL 不能假定两次调用可以相互替换。
STABLE 承诺:在同一条语句执行期间,对于相同的参数,函数始终返回相同的结果,并且不修改数据库。这样的函数可以在查询执行期间计算一次,然后复用计算出的值。
IMMUTABLE 的承诺更强:对于相同的参数,结果永远相同。因此,参数为常量的调用可以在规划阶段折叠。
这些类别只是允许优化器进行某些处理,并不规定精确的执行时机和次数。STABLE 并不意味着每个 STABLE 函数在所有情形下都恰好执行一次;它意味着在计划允许的情况下,优化器可以将参数相同的重复求值视为等价。
错误的标签可能产生错误结果。如果函数依赖时间、配置、表内容或其他会变化的状态,却被标记为 IMMUTABLE,就可能将一个过时的值固定在可复用的计划中。
为 random() 创建一个包装函数:
CREATE FUNCTION rnd() RETURNS float
LANGUAGE sql VOLATILE
RETURN random();
使用正确的 VOLATILE 标签时,谓词会对每一行求值:
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;

                   QUERY PLAN
------------------------------------------------
 Function Scan on generate_series
   Filter: (random() > '0.5'::double precision)
(2 rows)
一次执行可能返回这十行中的任意子集:
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;

 generate_series
-----------------
               1
               3
               4
               9
              10
(5 rows)
现在向 PostgreSQL 提供一个不真实的声明:
ALTER FUNCTION rnd() STABLE;
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;

                      QUERY PLAN
------------------------------------------------------
 Result
   One-Time Filter: (rnd() > '0.5'::double precision)
   -> Function Scan on generate_series
(3 rows)
在这个计划中,STABLE 表达式成为 One-Time Filter,因此结果要么包含全部十行,要么一行也没有:
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;

 generate_series
-----------------
(0 rows)
将包装函数标记为 IMMUTABLE,会给规划器更大的处理空间:
ALTER FUNCTION rnd() IMMUTABLE;
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;

        QUERY PLAN
--------------------------
 Result
   One-Time Filter: false
(2 rows)

EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;

           QUERY PLAN
---------------------------------
Function Scan on generate_series
(2 rows)
两次独立的规划可能将不同的随机结果固定下来。这些出人意料的计划不是 PostgreSQL 的错误,而是因为我们向优化器作出了不真实的承诺。
8.2.2 函数内联
对于满足条件的 SQL 语言函数,PostgreSQL 可以将函数体内联到外层查询中,标量函数和返回集合的函数都可以如此。6 两种情况都有许多限制:函数必须用 SQL 编写,只使用一条 SELECT 语句,并满足其他条件。标量函数不能访问数据库表,也不能调用稳定性类别更宽松的函数;返回集合的函数则必须是 STABLE 或 IMMUTABLE。
内联很重要,因为从规划器的角度看,它消除了函数边界。外层查询中的谓词有时就可以下推到函数体内部,连接顺序也可以跨越原有的函数边界进行调整。
简单标量 SQL 函数的函数体,可以在规划前直接替换进主 SQL 语句。此时,就没有函数调用开销。
对于标量 SQL 函数,限制条件包括稳定性类别必须一致。声明为 STABLE 的函数,如果函数体调用了 random() 这样的 VOLATILE 操作,就不能安全地内联。将 rnd() 标记为 STABLE:
ALTER FUNCTION rnd() STABLE;
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;

                      QUERY PLAN
------------------------------------------------------
 Result
   One-Time Filter: (rnd() > '0.5'::double precision)
   -> Function Scan on generate_series
(3 rows)
包装函数仍然出现在计划中。
恢复与实际行为相符的稳定性类别:
ALTER FUNCTION rnd() VOLATILE;
EXPLAIN (costs off)
SELECT * FROM generate_series(1,10) WHERE rnd() > 0.5;

                   QUERY PLAN
------------------------------------------------
 Function Scan on generate_series
   Filter: (random() > '0.5'::double precision)
(2 rows)
现在,过滤条件引用的是 random(),直接调用它,绕过了 rnd() 包装函数。
8.2.3 调用返回集合的函数
当返回集合的函数作为表表达式出现在 FROM 中时,PostgreSQL 用 Function Scan 表示它。此时,会先物化函数返回的全部行,再传给父计划节点。这是当前实现的一个限制。
当返回集合的表达式出现在目标列表中时,PostgreSQL 使用 ProjectSet,可以按需生成行。SQL 函数、大多数用 C 编写的内置函数,以及返回迭代器的 PL/Python 函数,都可以这样工作。其他编程语言的函数,如果其语言实现支持同一接口,也可以采用这种方式。
使用 LIMIT 时,两者的差别可能非常大。在 FROM 中调用 generate_series:
EXPLAIN (analyze, costs off, buffers off)
SELECT * FROM generate_series(1,10_000_000)
LIMIT 10;

                         QUERY PLAN
------------------------------------------------------------
 Limit (actual time=290.495..290.497 rows=10.00 loops=1)
   -> Function Scan on generate_series (actual time=290....
 Planning Time: 0.025 ms
 Execution Time: 296.988 ms
(4 rows)
现在,将返回集合的函数放入目标列表:
EXPLAIN (analyze, costs off, buffers off)
SELECT generate_series(1,10_000_000)
LIMIT 10;

                         QUERY PLAN
------------------------------------------------------------
 Limit (actual time=0.002..0.003 rows=10.00 loops=1)
   -> ProjectSet (actual time=0.001..0.002 rows=10.00 lo...
       -> Result (actual time=0.000..0.000 rows=1.00 loo...
 Planning Time: 0.020 ms
 Execution Time: 0.010 ms
(5 rows)
第一个计划中,Function Scan 先获取函数的全部结果行,再应用 Limit。第二个计划中,ProjectSet 只生成十行,恰好满足 Limit 的请求,查询执行时间降低了几个数量级。Result 节点对应省略了 FROM 子句的情形,向父节点传递恰好一行。
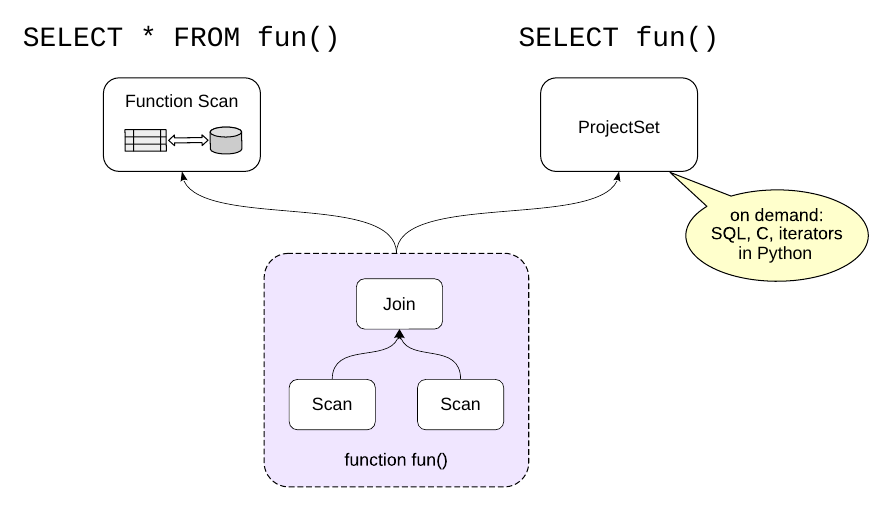
这并不意味着所有函数语言都能以流式方式返回行。例如,PL/pgSQL 返回集合的函数目前会先物化全部结果,再将它们交给调用方的执行器接口。
CREATE FUNCTION plpgsql_rows() RETURNS SETOF integer
AS $$
BEGIN
  RETURN QUERY
    SELECT * FROM generate_series(1,10_000_000);
END
$$ LANGUAGE plpgsql;
CREATE FUNCTION

EXPLAIN (analyze, costs off, buffers off)
SELECT plpgsql_rows() LIMIT 10;

                         QUERY PLAN
------------------------------------------------------------
 Limit (actual time=652.500..652.502 rows=10.00 loops=1)
   -> ProjectSet (actual time=652.499..652.500 rows=10.0...
       -> Result (actual time=0.000..0.000 rows=1.00 loo...
 Planning Time: 0.020 ms
 Execution Time: 660.376 ms
(5 rows)
计划中仍然有 ProjectSet,但函数实现必须在返回第一行之前,先完成那些开销很大的工作。执行时间清楚地说明了这一点。
8.2.4 COST 与 ROWS
当函数不能内联时,规划器往往只能在很大程度上将它视为黑盒。CREATE FUNCTION 允许我们提供两项重要的估算信息。
COST 是预估执行成本,以 cpu_operator_cost 为单位。对于返回集合的函数,它表示每个返回行的成本。7
ROWS 是返回集合的函数预期返回的行数。
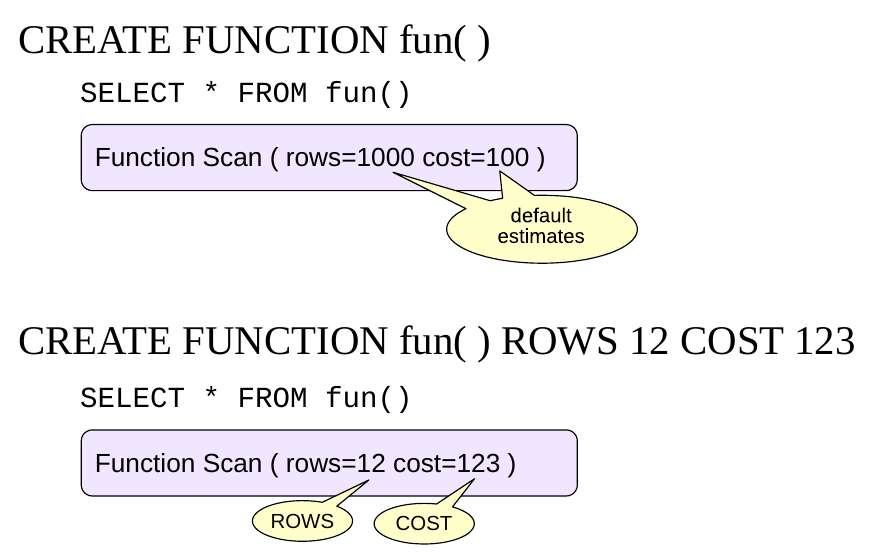
创建一个返回一周各天名称的 PL/pgSQL 函数:
CREATE FUNCTION days_of_week() RETURNS SETOF text
AS $$
BEGIN
  FOR i IN 7 .. 13 LOOP
    RETURN NEXT to_char(to_date(i::text,'J'),'TMDy');
  END LOOP;
END;
$$ LANGUAGE plpgsql;
CREATE FUNCTION
SELECT * FROM days_of_week();
days_of_week
--------------
Mon
Tue
Wed
Thu
Fri
Sat
Sun
(7 rows)查询计划如下:
EXPLAIN SELECT * FROM days_of_week();

               QUERY PLAN
-----------------------------------------
 Function Scan on days_of_week
   (cost=0.25..10.25 rows=1000 width=32)
(2 rows)
服务器将这个函数结果的基数估算为 1000 行,而实际只有七行。
启动成本部分反映了函数成本估算:
SELECT 100 * current_setting('cpu_operator_cost')::float;

 ?column?
----------
     0.25
(1 row)
提高函数成本:
ALTER FUNCTION days_of_week COST 10000;
EXPLAIN SELECT * FROM days_of_week();

                QUERY PLAN
------------------------------------------
 Function Scan on days_of_week
   (cost=25.00..35.00 rows=1000 width=32)
(2 rows)
设置函数预期返回的行数:
ALTER FUNCTION days_of_week ROWS 10;
EXPLAIN SELECT * FROM days_of_week();

               QUERY PLAN
----------------------------------------
 Function Scan on days_of_week
   (cost=25.00..25.10 rows=10 width=32)
(2 rows)
得到的预估成本为:
SELECT 10000 * current_setting('cpu_operator_cost')::float
  + 10 * current_setting('cpu_tuple_cost')::float;

 ?column?
----------
     25.1
(1 row)
可以通过 pg_proc 或元命令查看这些值:
SELECT procost, prorows
 FROM pg_proc WHERE proname='days_of_week';

 procost | prorows
---------+---------
   10000 |      10
(1 row)

\sf days_of_week
CREATE OR REPLACE FUNCTION bookings.days_of_week()
 RETURNS SETOF text
 LANGUAGE plpgsql
 COST 10000 ROWS 10
AS $function$
BEGIN
  FOR i IN 7 .. 13 LOOP
    RETURN NEXT to_char(to_date(i::text,'J'),'TMDy');
  END LOOP;
END;
$function$
8.2.5 规划器支持函数
COST 和 ROWS 子句让我们以常量形式指定函数成本和行数。但固定值并不总是足够准确。8
在 PostgreSQL 中,一个目标函数可以关联一个规划器支持函数,根据目标函数的实参值,向规划器提供相应的信息。
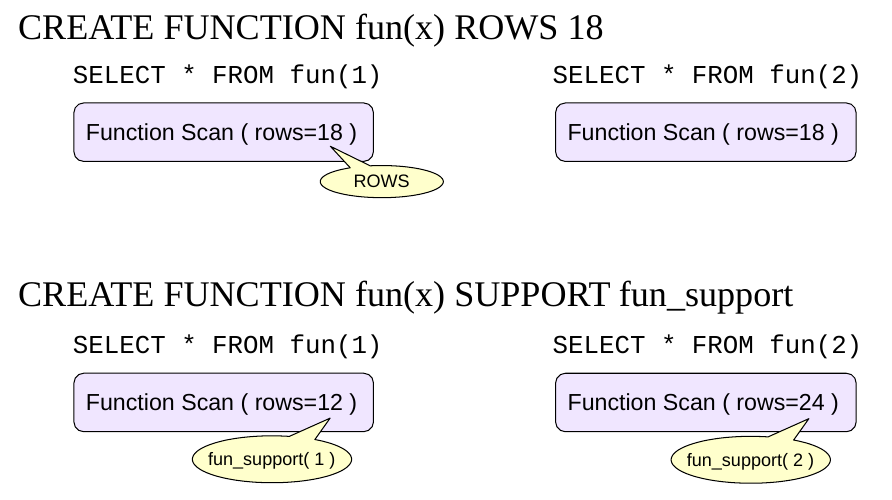
支持函数可以提供的信息包括:
- 函数成本的估算。
- 返回行数的估算。
- 与函数调用等价的表达式。
对于布尔函数,还可以提供:
- 选择率估算。
- 使用可索引操作符的等价谓词。
规划器支持函数使用 PostgreSQL 内部的规划器 API,目前必须用 C 编写。
8.2.6 并行安全标签
并非所有查询都能并行运行。规划器无法安全地推断用户定义函数可能产生的所有影响,因此并行执行依赖显式的函数标签。9
函数可以标记为:
- PARALLEL UNSAFE:只要查询中出现这个函数,就不能生成并行计划。
- PARALLEL RESTRICTED:可以参与使用并行执行的查询,但函数本身只能在并行组的领导者进程中执行。
- PARALLEL SAFE:可以在并行工作进程中执行。
用户定义函数的默认标签是 PARALLEL UNSAFE。用户定义的聚合函数也需要指定并行安全标签。
所有基本的标准函数都是并行安全的。
SELECT proparallel, count(*)
FROM pg_proc
GROUP BY proparallel;

 proparallel | count
-------------+-------
 r           |   202
 s           |  3374
 u           |   109
(3 rows)
具体数量取决于已经安装的扩展和 PostgreSQL 的小版本。
psql 也会显示这个标签:
\x \df+ random numeric \x
Expanded display is on.
List of functions
-[ RECORD 1 ]-------+-------------------------
Schema              | pg_catalog
Name                | random
Result data type    | numeric
Argument data types | min numeric, max numeric
Type                | func
Volatility          | volatile
Parallel            | restricted
Owner               | postgres
Security            | invoker
Leakproof?          | no
Access privileges   |
Language            | internal
Internal name       | numeric_random
Description         | random numeric in range
Expanded display is off.
现在创建一个函数,计算一张机票所有航段的价格之和:
CREATE FUNCTION ticket_price(ticket_no char(13))
RETURNS numeric
LANGUAGE plpgsql STABLE PARALLEL SAFE
AS $$
BEGIN
  RETURN (SELECT sum(price)
          FROM segments s
          WHERE s.ticket_no = ticket_price.ticket_no
  );
END;
$$;
CREATE FUNCTION
在一个子查询中使用它,再将总额与另一个子查询得到的预订总金额比较:
EXPLAIN (costs off) SELECT
  (SELECT sum(ticket_price(ticket_no)) FROM tickets) =
  (SELECT sum(total_amount) FROM bookings);

                    QUERY PLAN
--------------------------------------------------
 Result
   InitPlan 1
     -> Finalize Aggregate
         -> Gather
             Workers Planned: 2
             -> Partial Aggregate
                 -> Parallel Seq Scan on tickets
   InitPlan 2
     -> Finalize Aggregate
         -> Gather
             Workers Planned: 2
             -> Partial Aggregate
                 -> Parallel Seq Scan on bookings
(13 rows)
函数标记为 SAFE 时,两个子查询都可以使用并行计划。
将它标记为 UNSAFE:
ALTER FUNCTION ticket_price PARALLEL UNSAFE;
EXPLAIN (costs off) SELECT
  (SELECT sum(ticket_price(ticket_no)) FROM tickets) =
  (SELECT sum(total_amount) FROM bookings);

           QUERY PLAN
---------------------------------
 Result
   InitPlan 1
     -> Aggregate
         -> Seq Scan on tickets
   InitPlan 2
     -> Aggregate
         -> Seq Scan on bookings
(7 rows)
一个 UNSAFE 函数,就会禁用整条语句的并行查询。
现在将它标记为 RESTRICTED:
ALTER FUNCTION ticket_price PARALLEL RESTRICTED;
EXPLAIN (costs off) SELECT
  (SELECT sum(ticket_price(ticket_no)) FROM tickets) =
  (SELECT sum(total_amount) FROM bookings);

                    QUERY PLAN
--------------------------------------------------
 Result
   InitPlan 1
     -> Aggregate
         -> Seq Scan on tickets
   InitPlan 2
     -> Finalize Aggregate
         -> Gather
             Workers Planned: 2
             -> Partial Aggregate
                 -> Parallel Seq Scan on bookings
(10 rows)
调用 RESTRICTED 函数的子查询必须在领导者进程中运行,而独立的 bookings 子查询仍然可以使用并行工作进程。
SAFE 标签不只是一个性能提示。错误的标签可能导致报错或错误结果。无法确定时,应使用限制更严格的标签。