本章目录
第 6 章:统计信息
6.1 基础统计信息
PostgreSQL 在两个层级收集规划器所需的基础统计信息:整个关系,以及各个列。
6.1.1 表级统计信息
关系级统计信息包含关系大小的估算值,即 pg_class 中的 reltuples 和 relpages 列。1 这些值十分重要,因此 PostgreSQL 不仅会在 VACUUM 和 ANALYZE 期间更新它们,也会在某些 DDL 操作之后更新,例如 CREATE INDEX 和 CREATE TABLE AS。
如果当前物理文件大小与已存储的行数估算所依据的 relpages 不一致,规划器还可以按比例调整行数估算。这样,即使尚未进行下一次完整的统计信息更新,估算值也能反映表的增长。
ANALYZE 从行中随机采样,而不是为了收集各列的统计信息而读取整个表。所需的样本大小不会随着表的增长而增加,而是由 default_statistics_target 乘以 300 决定。
SELECT current_setting('default_statistics_target')::int
  * 300 AS rows_in_sample;

 rows_in_sample
----------------
          30000
(1 row)
对于大表,从样本得到的估算值不会完全准确。规划器通常只需要足以区分候选计划优劣的精度。数量级上的误差可能带来严重后果,而较小的采样误差往往不会。
来看一个没有谓词的查询:
EXPLAIN SELECT * FROM flights;

                QUERY PLAN
-------------------------------------------
 Seq Scan on flights
   (cost=0.00..744.71 rows=37671 width=51)
(2 rows)
行数估算来自 pg_class:
SELECT reltuples, relpages FROM pg_class
WHERE relname = 'flights';

 reltuples | relpages
-----------+----------
     37671 |      368
(1 row)
在这个例子中,它恰好与精确计数一致:
SELECT count(*) FROM flights;

 count
-------
 37671
(1 row)
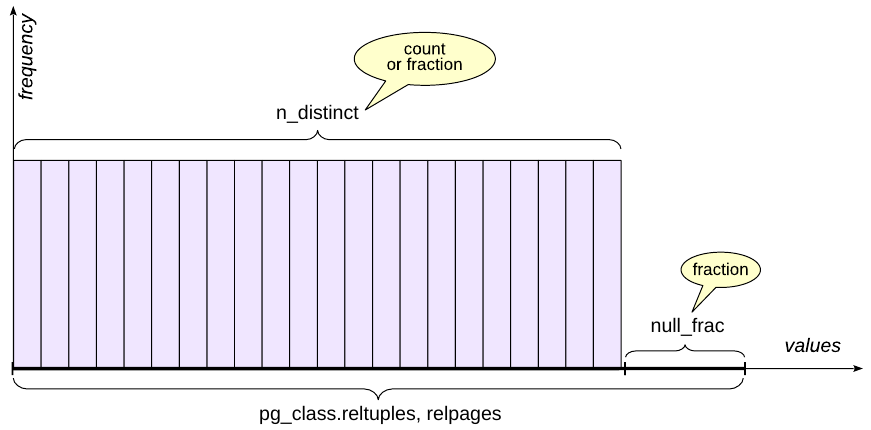
其余基础统计信息由 ANALYZE 按列收集,内部表示存储在 pg_statistic 中。pg_stats 视图以更易读的形式提供其中最有用的字段,同时遵守访问权限限制。
6.1.2 空值比例
pg_stats.null_frac 存储列值为 null 的行所占的比例,取值范围为 0 到 1。
有些航班尚未起飞,因此 actual_departure 仍为 null:
EXPLAIN SELECT *
FROM flights WHERE actual_departure IS NULL;

                QUERY PLAN
-------------------------------------------
 Seq Scan on flights
   (cost=0.00..744.71 rows=10755 width=51)
   Filter: (actual_departure IS NULL)
(3 rows)
规划器将关系的估算行数乘以 null_frac,得到结果行数的估算值:
SELECT round(37671 * null_frac) FROM pg_stats
WHERE tablename = 'flights'
  AND attname = 'actual_departure';

 round
-------
 10755
(1 row)
精确计数与之接近,但并不相同:
SELECT count(*) FROM flights
WHERE actual_departure IS NULL;

 count
-------
 10806
(1 row)
6.1.3 非重复值的数量
pg_stats.n_distinct 存储列中非 null 的非重复值数量的估算值。正值表示估算的绝对数量;负值则以取负的形式表示非重复值数量与行数之比。例如,-1 表示所有值都不重复,主键通常就是这种情况。采用负值表示的好处是,这一估算可以随表的增长自然调整。
6.1.4 高频值
如果每个值出现的频率都相同,仅凭非重复值的数量,就能很好地估算等值谓词。然而,实际数据很少如此理想。因此,PostgreSQL 还存储了两项信息:
- pg_stats.most_common_vals:高频值数组,也称为 MCV 列表。
- pg_stats.most_common_freqs:对应的频率数组。
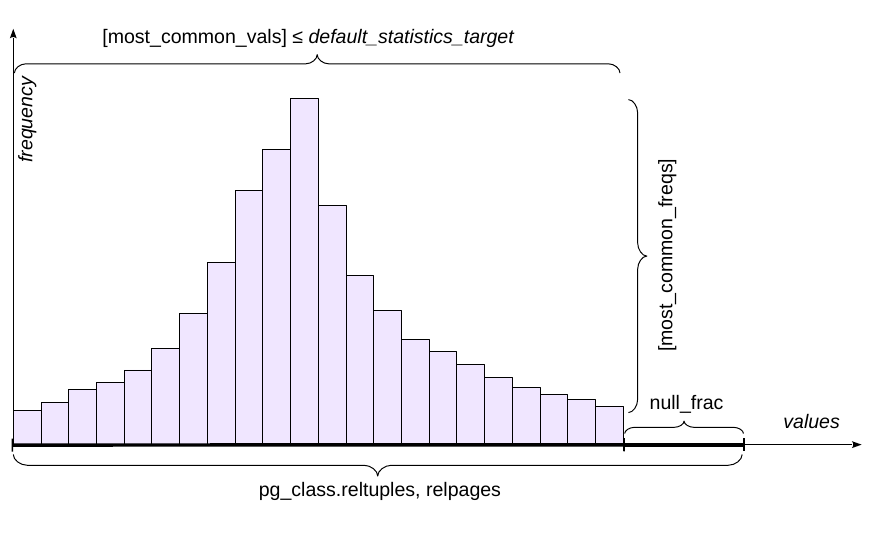
对于 MCV 列表中的值,可以直接用所存储的频率作为选择率估算。列表的最大条目数由统计目标值控制。default_statistics_target 提供默认值,也可以通过 ALTER TABLE … ALTER COLUMN … SET STATISTICS 为单个列单独设置。增大统计目标值,还会增大 ANALYZE 使用的样本。
为了避免 pg_statistic 过度膨胀,也避免规划器进行无用的工作,大于 1 kB 的值会被排除在统计和分析之外。这些大值很可能各不相同,本来也不太可能出现在 most_common_vals 中。
为了进行实验,先降低到达机场这一列的统计目标值:
ALTER TABLE routes
ALTER COLUMN arrival_airport SET STATISTICS 10;
ANALYZE routes;
孟买 (BOM) 出现得足够频繁,因此会进入 MCV 列表:
EXPLAIN SELECT *
FROM routes WHERE arrival_airport = 'BOM';

                 QUERY PLAN
---------------------------------------------
 Seq Scan on routes
   (cost=0.00..59.38 rows=55 width=103)
   Filter: (arrival_airport = 'BOM'::bpchar)
(3 rows)
精确计数也是 55:
SELECT count(*) FROM routes WHERE arrival_airport = 'BOM';

 count
-------
    55
(1 row)
查看高频值及其频率:
SELECT unnest(most_common_vals::text::text[]) AS mcv,
       unnest(most_common_freqs::text::float[]) AS mcf
FROM pg_stats
WHERE tablename = 'routes'
  AND attname = 'arrival_airport'
ORDER BY 2 DESC;

 mcv |     mcf
-----+-------------
 BOM | 0.027093597
 FRA | 0.026108375
 SVO | 0.026108375
 DEL | 0.021182265
 ATL | 0.020689655
 BLR | 0.020689655
 CAN | 0.020689655
 TFU | 0.020197045
 CDG | 0.019211823
 HND | 0.019211823
(10 rows)
基数估算就是 routes 的行数乘以所存储的频率:
SELECT round(
  2030 * most_common_freqs[
    array_position((most_common_vals::text::text[]),'BOM')
  ]
)
FROM pg_stats
WHERE tablename = 'routes'
  AND attname = 'arrival_airport';

 round
-------
    55
(1 row)
MCV 数据也可以用于不等式条件的估算:PostgreSQL 可以将满足范围条件的 MCV 条目的频率相加。
如果某个值不在 MCV 列表中,规划器就会假定剩余值均匀分布,据此进行估算。
圣地亚哥 (SCL) 不在这个包含十个值的 MCV 列表中:
EXPLAIN SELECT *
FROM routes
WHERE arrival_airport = 'SCL';

                 QUERY PLAN
---------------------------------------------
 Seq Scan on routes
   (cost=0.00..59.38 rows=25 width=103)
   Filter: (arrival_airport = 'SCL'::bpchar)
(3 rows)
精确计数为 18:
SELECT count(*) FROM routes
WHERE arrival_airport = 'SCL';

 count
-------
    18
(1 row)
为了得到估算值,规划器先对高频值的频率求和:
SELECT sum(f)
FROM pg_stats s, unnest(s.most_common_freqs) f
WHERE s.tablename = 'routes'
  AND s.attname = 'arrival_airport';

    sum
------------
 0.22118227
(1 row)
这一列有 73 个非重复值:
SELECT n_distinct
FROM pg_stats
WHERE tablename = 'routes' AND attname = 'arrival_airport';

 n_distinct
------------
         73
(1 row)
其中十个已经明确列在 MCV 列表中。在没有空值的情况下,剩余的概率总量近似均匀地分配给其余 63 个值:
SELECT round( 2030 * (1 - 0.22118227) / (73 - 10) );

 round
-------
    25
(1 row)
6.1.5 直方图
如果非重复值太多,无法通过 MCV 列表有效描述,PostgreSQL 还会构建直方图。
直方图由若干个包含取值的桶组成。桶的数量同样由 default_statistics_target 参数控制。
桶边界的选择使每个桶包含的取值数量近似相同,图中以面积相等的矩形表示。采用这种构造方式,PostgreSQL 只需在 pg_stats.histogram_bounds 中存储边界值数组。每个桶的频率为 。
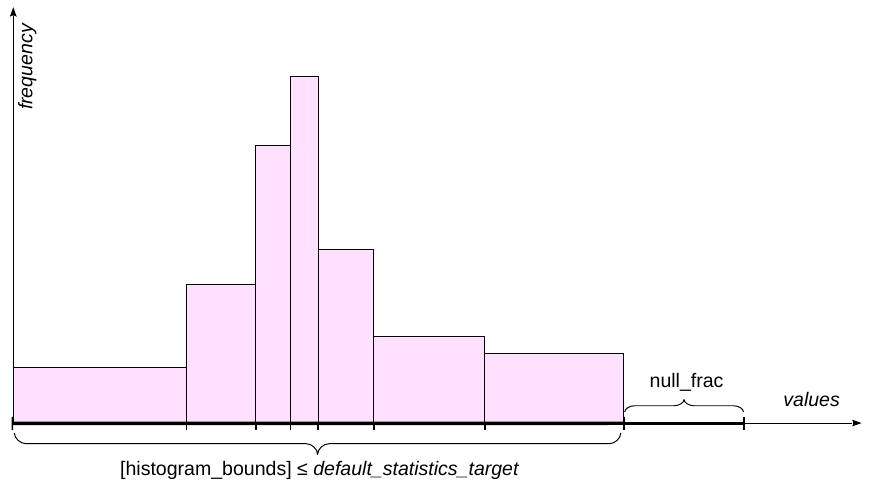
对于 field < value 这样的不等式条件,规划器会估算直方图中位于边界值左侧的部分占多少。它不仅可以计入完整的桶,还可以在包含该边界值的桶内进行插值。
MCV 值和空值不参与直方图的构建:
SELECT histogram_bounds FROM pg_stats
WHERE tablename = 'routes'
AND attname = 'arrival_airport';

               histogram_bounds
-----------------------------------------------
 {AER,CKG,DFW,HEL,KZN,LHR,MXP,PKX,SVX,YEG,YYZ}
(1 row)
因此,范围条件的选择率需要结合 MCV 列表和直方图两方面的信息。
来看下面的查询:
EXPLAIN SELECT *
FROM routes WHERE arrival_airport <= 'DFW';

                  QUERY PLAN
----------------------------------------------
 Seq Scan on routes
   (cost=0.00..59.38 rows=579 width=103)
   Filter: (arrival_airport <= 'DFW'::bpchar)
(3 rows)
精确计数为:
SELECT count(*) FROM routes WHERE arrival_airport <= 'DFW';

 count
-------
   609
(1 row)
落在所查询区间内的 MCV 值贡献了以下频率:
SELECT sum( s.most_common_freqs[
  array_position( (s.most_common_vals::text::text[]),v )
] )
FROM pg_stats s,
  unnest(s.most_common_vals::text::text[]) v
WHERE s.tablename = 'routes'
  AND s.attname = 'arrival_airport'
  AND v <= 'DFW';

    sum
------------
 0.12955666
(1 row)
在这个例子中,DFW 恰好是第二个桶的右边界,因此十个直方图桶中有两个落在该区间内。这里没有空值,所以估算结果为:
SELECT round(
  2030 * ( 0.12955666 + (1 - 0.22118227) * (2.0 / 10.0) )
);

 round
-------
   579
(1 row)
如果边界值落在桶内部,PostgreSQL 会根据数据类型和操作符,使用适当的插值方法细化估算。
对于不在 MCV 列表中的值,如果查询使用的是等值条件,直方图的作用就小得多。此时,PostgreSQL 会退回到基于剩余非重复值数量的估算方式。
6.1.6 其他统计字段
还有几个统计字段会影响查询规划。
pg_stats.correlation 衡量列值的逻辑顺序与行的物理顺序之间的统计相关性。2 接近 1 或 -1 表示物理顺序与列值顺序高度相关,接近零则表示相关性很弱。这会影响索引扫描的成本估算,因为较强的相关性意味着预期的堆随机访问更少。
pg_class.relallvisible 存储可见性映射中标为 all-visible 的表页面数量。all-visible 页面中的所有元组都已知对当前和未来的所有事务可见。如果这样的页面不够多,规划器可能会选择位图扫描,而不是仅索引扫描。
pg_stats.avg_width 存储列值的平均大小,单位为字节,用于估算操作所需的内存。
6.1.7 custom plan 与 generic plan
使用简单查询协议时 (见第 2 章“规划与执行”),一条语句通常在每次执行时,都作为新语句重新进行解析、规划和执行。
扩展查询协议允许预备语句,这些语句可以带有参数。语法树保存在后端进程的本地内存中,规划则可以推迟到参数值已知时再进行。
custom plan 针对某一次执行,使用这次执行的实际参数值生成。数据分布倾斜时,这很有用,因为不同的参数值可能对应不同的最优访问方法。例如,对于很少出现的值,索引可能非常有效;对于十分常见的值,索引却可能不如顺序扫描。
generic plan 的生成不使用实际参数值,可以在多次执行之间复用,从而节省规划时间。当数据均匀分布、条件的选择率不取决于具体参数值时,generic plan 尤其适用。
预备一个查询,并创建索引:
PREPARE f(text) AS
SELECT * FROM flights WHERE status = $1;
CREATE INDEX ON flights(status);
已取消的航班足够少,适合使用索引扫描:
EXPLAIN EXECUTE f('Cancelled');

                   QUERY PLAN
------------------------------------------------
 Index Scan using flights_status_idx on flights
   (cost=0.29..59.43 rows=210 width=51)
   Index Cond: (status = 'Cancelled'::text)
(3 rows)
已到达的航班则很多,因此 custom plan 选择顺序扫描:
EXPLAIN EXECUTE f('Arrived');

                QUERY PLAN
-------------------------------------------
 Seq Scan on flights
   (cost=0.00..838.89 rows=26900 width=51)
   Filter: (status = 'Arrived'::text)
(3 rows)
再执行三次语句,使使用 custom plan 的总次数达到五次:
EXECUTE f('Arrived');
EXECUTE f('Arrived');
EXECUTE f('Arrived');
可以在 pg_prepared_statements 中查看计数:
SELECT name, generic_plans, custom_plans
FROM pg_prepared_statements;

 name | generic_plans | custom_plans
------+---------------+--------------
 f    |             0 |            5
(1 row)
本例在下一次执行时切换到 generic plan。generic plan 显示的是参数符号,而不是具体值:
EXPLAIN EXECUTE f('Arrived');

                         QUERY PLAN
------------------------------------------------------------
 Index Scan using flights_status_idx on flights  (cost=0...
   Index Cond: (status = $1)
(2 rows)
SELECT name, generic_plans, custom_plans
FROM pg_prepared_statements;
name | generic_plans | custom_plans
------+---------------+--------------
f | 1 | 5
(1 row)对于倾斜分布的数据,这种切换可能并不理想。可以通过 plan_cache_mode 覆盖自动选择所使用的启发式规则:
SHOW plan_cache_mode;

 plan_cache_mode
-----------------
 auto
(1 row)

SET plan_cache_mode = 'force_custom_plan';
EXPLAIN EXECUTE f('Arrived');

                         QUERY PLAN
------------------------------------------------------------
 Seq Scan on flights  (cost=0.00..838.89 rows=26900 widt...
   Filter: (status = 'Arrived'::text)
(2 rows)

RESET plan_cache_mode;
6.2 扩展统计信息
自动收集的基础统计信息,可能不足以准确估算基数和选择率。
PostgreSQL 允许管理员手动指定还需要哪些额外的统计信息,即扩展统计信息。3 你可以收集同时涵盖多个列的统计信息 (多元统计信息),也可以收集任意表达式的统计信息。
需要注意,基础统计信息针对表及其列收集,而不针对索引收集,表达式索引除外。因此,仅仅创建多列索引,并不会同时创建多元统计信息。
扩展统计信息通过 CREATE STATISTICS 命令创建。定义存储在 pg_statistic_ext 中,收集到的数据存储在 pg_statistic_ext_data 中。
PostgreSQL 提供了几种不同类型的多元统计信息。
6.2.1 函数依赖
函数依赖描述一列的值在多大程度上决定另一列的值。4
| city | index |
|---|---|
| Samara | 443000 |
| Kazan | 420000 |
| Nizhny Novgorod | 603000 |
| Veliky Novgorod | 173000 |
例如,如果邮政编码可以唯一确定城市,那么 city 和 postal_code 上的谓词就是相关的,如上表所示。
来看 routes 上的两个谓词:
SELECT count(*) FROM routes
WHERE route_no = 'PG0085' AND arrival_airport = 'FCO';

 count
-------
     7
(1 row)
没有扩展统计信息时,估算值过低:
EXPLAIN SELECT * FROM routes
WHERE route_no = 'PG0085' AND arrival_airport = 'FCO';

                       QUERY PLAN
---------------------------------------------------------
 Bitmap Heap Scan on routes
   (cost=4.20..22.77 rows=1 width=103)
   Recheck Cond: (route_no = 'PG0085'::text)
   Filter: (arrival_airport = 'FCO'::bpchar)
   -> Bitmap Index Scan on routes_route_no_validity_excl
       (cost=0.00..4.20 rows=7 width=0)
       Index Cond: (route_no = 'PG0085'::text)
(7 rows)
原因在于,规划器假定谓词之间互相独立,并将逻辑 AND 连接的各个条件的选择率相乘,作为整体选择率。执行计划清楚地显示了这一点:Bitmap Index Scan 节点针对 route_no 条件的估算是正确的,但经过 Bitmap Heap Scan 节点按 arrival_airport 过滤后,估算值就偏低了。然而,我们知道航线编号可以唯一确定到达机场,因此只要机场指定正确,第二个条件实际上是多余的。
创建函数依赖统计信息:
CREATE STATISTICS routes_dep(dependencies)
ON route_no, arrival_airport FROM routes;
ANALYZE routes;
查看依赖关系:
SELECT dependencies FROM pg_stats_ext
WHERE statistics_name = 'routes_dep';

     dependencies
----------------------
 {"1 => 4": 1.000000}
(1 row)
冒号后的数字表示测得的、这一属性映射的依赖程度。现在估算得到改善:
EXPLAIN SELECT * FROM routes
WHERE route_no = 'PG0085' AND arrival_airport = 'FCO';

                       QUERY PLAN
---------------------------------------------------------
 Bitmap Heap Scan on routes
   (cost=4.20..22.78 rows=7 width=103)
   Recheck Cond: (route_no = 'PG0085'::text)
   Filter: (arrival_airport = 'FCO'::bpchar)
   -> Bitmap Index Scan on routes_route_no_validity_excl
       (cost=0.00..4.20 rows=7 width=0)
       Index Cond: (route_no = 'PG0085'::text)
(7 rows)
psql 的元命令 \d routes 也会列出在该表上定义的统计信息对象。Statistics objects 部分显示它们的名称、列以及非默认的统计目标值:
 ...
Statistics objects:
    "bookings.routes_dep" (dependencies) ON route_no,
    arrival_airport FROM routes
6.2.2 高频值组合
列之间可能存在相关性,但并不构成任何方向的函数依赖。5 下表列出了可能的城市与河流组合。city 和 river 上的谓词显然相关,但与前一个例子不同,任何一列都不能决定另一列:城市与河流之间是多对多关系。
| city | river |
|---|---|
| Samara | Volga |
| Kazan | Volga |
| Nizhny Novgorod | Oka |
| Nizhny Novgorod | Volga |
| Veliky Novgorod | Volkhov |
示例数据库中也有类似的情况:
EXPLAIN (analyze, timing off, summary off, buffers off)
SELECT * FROM routes
WHERE departure_airport = 'BOM' AND airplane_code = '7M7';

                         QUERY PLAN
------------------------------------------------------------
 Bitmap Heap Scan on routes
   (cost=4.69..40.71 rows=9 width=103)
   (actual rows=17.00 loops=1)
   Recheck Cond: (departure_airport = 'BOM'::bpchar)
   Filter: (airplane_code = '7M7'::bpchar)
   Rows Removed by Filter: 38
   Heap Blocks: exact=27
   -> Bitmap Index Scan on routes_departure_airport_lowe...
       (cost=0.00..4.69 rows=55 width=0)
       (actual rows=55.00 loops=1)
       Index Cond: (departure_airport = 'BOM'::bpchar)
       Index Searches: 1
(12 rows)
规划器低估了行数。为这两列建立 MCV 统计信息后,估算就正确了:
CREATE STATISTICS (mcv)
ON departure_airport, airplane_code FROM routes;
ANALYZE routes;
EXPLAIN SELECT * FROM routes
WHERE departure_airport = 'BOM' AND airplane_code = '7M7';

                         QUERY PLAN
------------------------------------------------------------
 Bitmap Heap Scan on routes
   (cost=4.69..40.72 rows=17 width=103)
   Recheck Cond: (departure_airport = 'BOM'::bpchar)
   Filter: (airplane_code = '7M7'::bpchar)
   -> Bitmap Index Scan on routes_departure_airport_lowe...
       (cost=0.00..4.69 rows=55 width=0)
       Index Cond: (departure_airport = 'BOM'::bpchar)
(7 rows)
可以使用 pg_mcv_list_items 函数查看多元 MCV 数据:
SELECT values, frequency
FROM pg_statistic_ext
  JOIN pg_statistic_ext_data ON oid = stxoid,
  pg_mcv_list_items(stxdmcv) m
WHERE stxname = 'routes_departure_airport_airplane_code_stat'
LIMIT 3;

  values   |      frequency
-----------+----------------------
 {FRA,77W} | 0.009852216748768473
 {BOM,7M7} | 0.008374384236453201
 {PVG,77W} | 0.008374384236453201
(3 rows)
6.2.3 非重复值组合
分组是另一种规划器可能估算出错的情况。多元 ndistinct 统计信息可以改善按多个列分组时的估算。6
在下面的例子中,所有字段可能形成的组合数,显然不能简单地通过各列非重复值数量相乘得到。
| city | region | index |
|---|---|---|
| Samara | Samara Oblast | 443000 |
| Kazan | Republic of Tatarstan | 420000 |
| Nizhny Novgorod | Nizhny Novgorod Oblast | 603000 |
| Veliky Novgorod | Novgorod Oblast | 173000 |
统计有直达航线的非重复机场对数量:
SELECT count(*) FROM (
  SELECT DISTINCT departure_airport, arrival_airport
  FROM routes
);

 count
-------
   932
(1 row)
没有多元非重复值统计信息时,规划器严重低估了分组数量:
EXPLAIN SELECT DISTINCT departure_airport, arrival_airport
FROM routes;

                   QUERY PLAN
-------------------------------------------------
 HashAggregate
   (cost=64.45..66.48 rows=203 width=8)
   Group Key: departure_airport, arrival_airport
   -> Seq Scan on routes
       (cost=0.00..54.30 rows=2030 width=8)
(5 rows)
创建一个扩展统计信息对象。如果不指定类型,PostgreSQL 会包含所有适用且受支持的多元统计信息类型:
CREATE STATISTICS
ON departure_airport, arrival_airport FROM routes;
ANALYZE routes;
EXPLAIN SELECT DISTINCT departure_airport, arrival_airport
FROM routes;

                   QUERY PLAN
-------------------------------------------------
 HashAggregate
   (cost=64.45..73.77 rows=932 width=8)
   Group Key: departure_airport, arrival_airport
   -> Seq Scan on routes
       (cost=0.00..54.30 rows=2030 width=8)
(5 rows)
估算得到了改善。查看存储的估算值:
SELECT n_distinct
FROM pg_stats_ext
WHERE statistics_name =
    'routes_departure_airport_arrival_airport_stat';

  n_distinct
---------------
 {"3, 4": 932}
(1 row)
\dX 可以列出扩展统计信息对象。统计值本身存储在 pg_statistic_ext_data 中。
6.2.4 表达式统计信息
扩展统计信息还可以为表达式收集常规的单变量统计信息,就像表中有一个存储该表达式结果的列一样。
| city | index | address |
|---|---|---|
| Samara | 443000 | 443000, Samara |
| Kazan | 420000 | 420000, Kazan |
| Nizhny Novgorod | 603000 | 603000, Nizhny Novgorod |
| Veliky Novgorod | 173000 | 173000, Veliky Novgorod |
表达式也可以与列或其他表达式一起参与多元统计信息的收集。
如果没有表达式统计信息,当谓词的操作数是表达式时,规划器由于缺少该表达式本身的分布数据,可能只能采用通用的默认选择率。例如:
EXPLAIN (analyze, timing off, summary off, buffers off)
SELECT * FROM flights
WHERE extract( month FROM scheduled_departure
               AT TIME ZONE 'Europe/Moscow' ) = 1;

                         QUERY PLAN
------------------------------------------------------------
 Seq Scan on flights
   (cost=0.00..1027.24 rows=188 width=51)
   (actual rows=5529.00 loops=1)
   Filter: (EXTRACT(month FROM (scheduled_departure AT T...
   Rows Removed by Filter: 32142
(5 rows)
估算值远低于实际行数。提供统计信息的一种方式是创建表达式索引,但即使查询访问并不需要这个索引,它仍会占用存储空间,并带来维护成本。如果目的只是改善估算,可以改为创建表达式统计信息:
CREATE STATISTICS
ON extract( month FROM scheduled_departure
            AT TIME ZONE 'Europe/Moscow' )
FROM flights;
ANALYZE flights;
EXPLAIN
SELECT * FROM flights
WHERE extract( month FROM scheduled_departure
AT TIME ZONE 'Europe/Moscow' ) = 1;
QUERY PLAN
------------------------------------------------------------
Seq Scan on flights
(cost=0.00..1027.24 rows=5561 width=51)
Filter: (EXTRACT(month FROM (scheduled_departure AT T...
(3 rows)现在估算值已接近实际值。
可以通过 pg_stats_ext_exprs 视图查看表达式统计信息:
SELECT statistics_name, left(expr,40) AS expr,
  n_distinct, most_common_vals
FROM pg_stats_ext_exprs \gx

-[ RECORD 1 ]----+-----------------------------------------
statistics_name  | flights_expr_stat
expr             | EXTRACT(month FROM (scheduled_departure
n_distinct       | 7
most_common_vals | {10,1,12,11,3,4,2}
清理本章创建的对象:
DROP INDEX flights_status_idx;
DROP INDEX
SELECT 'DROP STATISTICS ' || statistics_name
FROM pg_stats_ext \gexec
DROP STATISTICS
DROP STATISTICS
DROP STATISTICS
DROP STATISTICS